
Transformers documentation
FastSpeech2Conformer
Mô hình này được công bố trên HF papers vào ngày 2020-10-26 và được đóng góp cho Hugging Face Transformers vào ngày 2024-01-03.
FastSpeech2Conformer
Tổng quan
Mô hình FastSpeech2Conformer được đề xuất trong bài báo Recent Developments On Espnet Toolkit Boosted By Conformer của Pengcheng Guo, Florian Boyer, Xuankai Chang, Tomoki Hayashi, Yosuke Higuchi, Hirofumi Inaguma, Naoyuki Kamo, Chenda Li, Daniel Garcia-Romero, Jiatong Shi, Jing Shi, Shinji Watanabe, Kun Wei, Wangyou Zhang và Yuekai Zhang.
Tóm tắt từ bài báo gốc FastSpeech2 như sau:
Các mô hình tổng hợp giọng nói từ văn bản (TTS) không tự hồi quy như FastSpeech (Ren et al., 2019) có thể tổng hợp giọng nói nhanh hơn đáng kể so với các mô hình tự hồi quy trước đó với chất lượng tương đương. Việc huấn luyện mô hình FastSpeech dựa vào một mô hình giáo viên tự hồi quy cho dự đoán thời lượng (để cung cấp thêm thông tin đầu vào) và chưng cất kiến thức (để đơn giản hóa phân phối dữ liệu ở đầu ra), điều này có thể làm giảm bớt vấn đề ánh xạ một-đến-nhiều (tức là nhiều biến thể giọng nói tương ứng với cùng một văn bản) trong TTS. Tuy nhiên, FastSpeech có một số nhược điểm: 1) quy trình chưng cất giáo viên-trò phức tạp và tốn thời gian, 2) thời lượng trích xuất từ mô hình giáo viên không đủ chính xác, và các mel-spectrogram mục tiêu được chưng cất từ mô hình giáo viên bị mất thông tin do đơn giản hóa dữ liệu, cả hai điều này đều hạn chế chất lượng giọng nói. Trong bài báo này, chúng tôi đề xuất FastSpeech 2, giải quyết các vấn đề trong FastSpeech và giải quyết tốt hơn vấn đề ánh xạ một-đến-nhiều trong TTS bằng cách 1) huấn luyện trực tiếp mô hình với mục tiêu thực tế thay vì đầu ra đơn giản hóa từ mô hình giáo viên, và 2) đưa thêm thông tin biến thể của giọng nói (ví dụ: cao độ, năng lượng và thời lượng chính xác hơn) làm đầu vào có điều kiện. Cụ thể, chúng tôi trích xuất thời lượng, cao độ và năng lượng từ dạng sóng giọng nói và trực tiếp sử dụng chúng làm đầu vào có điều kiện trong huấn luyện và sử dụng các giá trị dự đoán trong suy luận. Chúng tôi thiết kế thêm FastSpeech 2s, đây là nỗ lực đầu tiên để trực tiếp tạo ra dạng sóng giọng nói từ văn bản song song, tận hưởng lợi ích của suy luận hoàn toàn end-to-end. Kết quả thực nghiệm cho thấy 1) FastSpeech 2 đạt tốc độ huấn luyện nhanh gấp 3 lần so với FastSpeech, và FastSpeech 2s có tốc độ suy luận còn nhanh hơn; 2) FastSpeech 2 và 2s vượt trội hơn FastSpeech về chất lượng giọng nói, và FastSpeech 2 thậm chí có thể vượt qua các mô hình tự hồi quy. Các mẫu âm thanh có sẵn tại https://speechresearch.github.io/fastspeech2/.
Mô hình này được đóng góp bởi Connor Henderson. Mã gốc có thể được tìm thấy tại đây.
🤗 Kiến trúc Mô hình
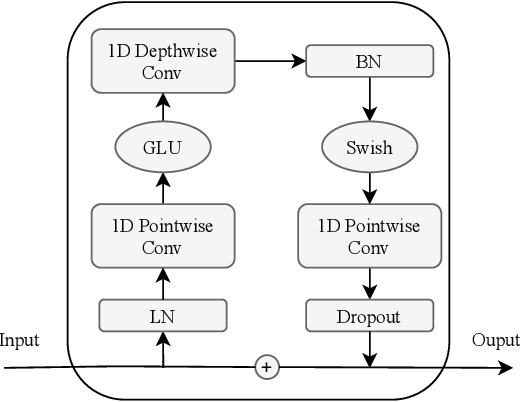
Cấu trúc tổng quát của FastSpeech2 với bộ giải mã Mel-spectrogram đã được triển khai, và các khối transformer truyền thống đã được thay thế bằng các khối conformer như đã thực hiện trong thư viện ESPnet.
Kiến trúc mô hình FastSpeech2

Các khối Conformer

Mô-đun卷积
🤗 Sử dụng Transformers
Bạn có thể chạy FastSpeech2Conformer cục bộ với thư viện 🤗 Transformers.
- Trước tiên, hãy cài đặt thư viện Transformers 🤗, g2p-en:
pip install --upgrade pip
pip install --upgrade transformers g2p-en
- Chạy suy luận thông qua mã mô hình của Transformers với model và hifigan riêng biệt
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerModel, FastSpeech2ConformerTokenizer


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer", device_map="auto")
output_dict = model(input_ids, return_dict=True)
spectrogram = output_dict["spectrogram"]

hifigan = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
waveform = hifigan(spectrogram)

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- Chạy suy luận thông qua mã mô hình của Transformers với mô hình và hifigan được kết hợp
import soundfile as sf

from transformers import FastSpeech2ConformerTokenizer, FastSpeech2ConformerWithHifiGan


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
output_dict = model(input_ids, return_dict=True)
waveform = output_dict["waveform"]

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- Chạy suy luận bằng pipeline và chỉ định vocoder cần sử dụng
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, pipeline


vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
synthesiser = pipeline(model="espnet/fastspeech2_conformer", vocoder=vocoder)

speech = synthesiser("Hello, my dog is cooler than you!")

sf.write("speech.wav", speech["audio"].squeeze(), samplerate=speech["sampling_rate"])
FastSpeech2ConformerConfig
lớp transformers.FastSpeech2ConformerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truehidden_size: int = 384vocab_size: int = 78num_mel_bins: int = 80encoder_num_attention_heads: int = 2encoder_layers: int = 4encoder_linear_units: int = 1536decoder_layers: int = 4decoder_num_attention_heads: int = 2decoder_linear_units: int = 1536speech_decoder_postnet_layers: int = 5speech_decoder_postnet_units: int = 256speech_decoder_postnet_kernel: int = 5positionwise_conv_kernel_size: int = 3encoder_normalize_before: bool = Falsedecoder_normalize_before: bool = Falseencoder_concat_after: bool = Falsedecoder_concat_after: bool = Falsereduction_factor: int = 1speaking_speed: float = 1.0use_macaron_style_in_conformer: bool = Trueuse_cnn_in_conformer: bool = Trueencoder_kernel_size: int = 7decoder_kernel_size: int = 31duration_predictor_layers: int = 2duration_predictor_channels: int = 256duration_predictor_kernel_size: int = 3energy_predictor_layers: int = 2energy_predictor_channels: int = 256energy_predictor_kernel_size: int = 3energy_predictor_dropout: float | int = 0.5energy_embed_kernel_size: int = 1energy_embed_dropout: float | int = 0.0stop_gradient_from_energy_predictor: bool = Falsepitch_predictor_layers: int = 5pitch_predictor_channels: int = 256pitch_predictor_kernel_size: int = 5pitch_predictor_dropout: float | int = 0.5pitch_embed_kernel_size: int = 1pitch_embed_dropout: float | int = 0.0stop_gradient_from_pitch_predictor: bool = Trueencoder_dropout_rate: float | int = 0.2encoder_positional_dropout_rate: float | int = 0.2encoder_attention_dropout_rate: float | int = 0.2decoder_dropout_rate: float | int = 0.2decoder_positional_dropout_rate: float | int = 0.2decoder_attention_dropout_rate: float | int = 0.2duration_predictor_dropout_rate: float | int = 0.2speech_decoder_postnet_dropout: float | int = 0.5max_source_positions: int = 5000use_masking: bool = Trueuse_weighted_masking: bool = Falsenum_speakers: int | None = Nonenum_languages: int | None = Nonespeaker_embed_dim: int | None = Noneconvolution_bias: bool = True )
Tham số
- is_encoder_decoder (
bool, tùy chọn, mặc định làTrue) — Xác định xem mô hình có được sử dụng như một encoder/decoder hay không. - hidden_size (
int, tùy chọn, mặc định là384) — Kích thước của các biểu diễn ẩn. - vocab_size (
int, tuỳ chọn, mặc định là78) — Kích thước từ vựng của mô hình. Xác định số lượng token khác nhau có thể được biểu diễn bởiinput_ids. - num_mel_bins (
int, tùy chọn, mặc định là80) — Số lượng đặc trưng mel được sử dụng cho mỗi khung đầu vào. Cần khớp với giá trị được dùng trong lớpAutoFeatureExtractor. - encoder_num_attention_heads (
int, tùy chọn, mặc định là 2) — Số lượng đầu chú ý trong encoder. - encoder_layers (
int, tùy chọn, mặc định là4) — Số lượng lớp ẩn trong bộ mã hóa Transformer. Nếu không được đặt, giá trị này sẽ giống vớinum_layers. - encoder_linear_units (
int, tùy chọn, mặc định là 1536) — Số lượng đơn vị trong lớp tuyến tính của bộ mã hóa. - decoder_layers (
int, tùy chọn, mặc định là4) — Số lượng lớp ẩn trong bộ giải mã Transformer. Nếu không được đặt, giá trị này sẽ giống vớinum_layers. - decoder_num_attention_heads (
int, tùy chọn, mặc định là2) — Số lượng đầu chú ý cho mỗi lớp chú ý trong bộ giải mã Transformer. - decoder_linear_units (
int, tùy chọn, mặc định là 1536) — Số lượng đơn vị trong lớp tuyến tính của bộ giải mã. - speech_decoder_postnet_layers (
int, tuỳ chọn, mặc định là 5) — Số lượng lớp trong post-net của speech decoder. - speech_decoder_postnet_units (
int, tùy chọn, mặc định là 256) — Số lượng đơn vị trong các lớp post-net của bộ giải mã giọng nói. - speech_decoder_postnet_kernel (
int, tùy chọn, mặc định là 5) — Kích thước kernel trong post-net của speech decoder. - positionwise_conv_kernel_size (
int, tùy chọn, mặc định là 3) — Kích thước của nhân tích chập được sử dụng trong lớp theo vị trí. - encoder_normalize_before (
bool, tùy chọn, mặc định làFalse) — Chỉ định có nên chuẩn hóa trước các lớp encoder hay không. - decoder_normalize_before (
bool, tùy chọn, mặc định làFalse) — Chỉ định có nên chuẩn hóa trước các lớp decoder hay không. - encoder_concat_after (
bool, tùy chọn, mặc định làFalse) — Chỉ định có nối (concatenate) sau các lớp encoder hay không. - decoder_concat_after (
bool, tùy chọn, mặc định làFalse) — Chỉ định có nối (concatenate) sau các lớp decoder hay không. - reduction_factor (
int, tùy chọn, mặc định là 1) — Hệ số giảm tần số khung âm thanh. - speaking_speed (
float, tùy chọn, mặc định là 1.0) — Tốc độ của giọng nói được tạo ra. - use_macaron_style_in_conformer (
bool, tùy chọn, mặc định làTrue) — Chỉ định việc có sử dụng macaron style trong conformer hay không. - use_cnn_in_conformer (
bool, tùy chọn, mặc định làTrue) — Chỉ định việc có sử dụng mạng nơ-ron tích chập trong conformer hay không. - encoder_kernel_size (
int, tùy chọn, mặc định là 7) — Kích thước kernel được sử dụng trong encoder. - decoder_kernel_size (
int, tùy chọn, mặc định là 31) — Kích thước kernel được sử dụng trong bộ giải mã. - duration_predictor_layers (
int, tùy chọn, mặc định là 2) — Số lượng lớp trong bộ dự đoán thời lượng. - duration_predictor_channels (
int, tùy chọn, mặc định là 256) — Số lượng kênh trong bộ dự đoán thời lượng. - duration_predictor_kernel_size (
int, tuỳ chọn, mặc định là 3) — Kích thước kernel được sử dụng trong bộ dự đoán thời lượng. - energy_predictor_layers (
int, tuỳ chọn, mặc định là 2) — Số lượng lớp trong bộ dự đoán năng lượng. - energy_predictor_channels (
int, tùy chọn, mặc định là 256) — Số lượng kênh trong bộ dự đoán năng lượng. - energy_predictor_kernel_size (
int, tuỳ chọn, mặc định là 3) — Kích thước kernel được sử dụng trong bộ dự đoán năng lượng. - energy_predictor_dropout (
float, tùy chọn, mặc định là 0.5) — Tỷ lệ dropout trong bộ dự đoán năng lượng. - energy_embed_kernel_size (
int, tùy chọn, mặc định là 1) — Kích thước kernel được sử dụng trong lớp energy embed. - energy_embed_dropout (
float, tùy chọn, mặc định là 0.0) — Tỷ lệ dropout trong lớp energy embed. - stop_gradient_from_energy_predictor (
bool, tùy chọn, mặc định làFalse) — Chỉ định có nên dừng gradient từ bộ dự đoán năng lượng hay không. - pitch_predictor_layers (
int, tùy chọn, mặc định là 5) — Số lượng lớp trong bộ dự đoán cao độ. - pitch_predictor_channels (
int, tùy chọn, mặc định là 256) — Số lượng kênh trong bộ dự đoán pitch. - pitch_predictor_kernel_size (
int, tùy chọn, mặc định là 5) — Kích thước kernel được sử dụng trong bộ dự đoán pitch. - pitch_predictor_dropout (
float, tùy chọn, mặc định là 0.5) — Tỷ lệ dropout trong bộ dự đoán pitch. - pitch_embed_kernel_size (
int, tùy chọn, mặc định là 1) — Kích thước kernel được sử dụng trong lớp pitch embed. - pitch_embed_dropout (
float, tùy chọn, mặc định là 0.0) — Tỷ lệ dropout trong lớp nhúng pitch. - stop_gradient_from_pitch_predictor (
bool, tùy chọn, mặc định làTrue) — Chỉ định có nên dừng gradient từ bộ dự đoán cao độ hay không. - encoder_dropout_rate (
float, tùy chọn, mặc định là 0.2) — Tỷ lệ dropout trong encoder. - encoder_positional_dropout_rate (
float, tùy chọn, mặc định là 0.2) — Tỷ lệ dropout vị trí trong encoder. - encoder_attention_dropout_rate (
float, tùy chọn, mặc định là 0.2) — Tỷ lệ dropout của cơ chế chú ý trong bộ mã hóa. - decoder_dropout_rate (
float, tùy chọn, mặc định là 0.2) — Tỷ lệ dropout trong bộ giải mã. - decoder_positional_dropout_rate (
float, tùy chọn, mặc định là 0.2) — Tỷ lệ dropout vị trí trong bộ giải mã. - decoder_attention_dropout_rate (
float, tùy chọn, mặc định là 0.2) — Tỷ lệ dropout của attention trong decoder. - duration_predictor_dropout_rate (
float, tùy chọn, mặc định là 0.2) — Tỷ lệ dropout trong bộ dự đoán thời lượng. - speech_decoder_postnet_dropout (
float, tùy chọn, mặc định là 0.5) — Tỷ lệ dropout trong postnet của speech decoder. - max_source_positions (
int, tùy chọn, mặc định là 5000) — nếu sử dụng position embeddings"relative", định nghĩa vị trí đầu vào nguồn tối đa. - use_masking (
bool, tùy chọn, mặc định làTrue) — Chỉ định có sử dụng masking trong mô hình hay không. - use_weighted_masking (
bool, tùy chọn, mặc định làFalse) — Chỉ định việc có sử dụng weighted masking trong mô hình hay không. - num_speakers (
int, tùy chọn) — Số lượng người nói. Nếu được đặt thành > 1, giả định rằng các id người nói sẽ được cung cấp dưới dạng đầu vào và sử dụng lớp nhúng id người nói. - num_languages (
int, tùy chọn) — Số lượng ngôn ngữ. Nếu được đặt thành > 1, giả định rằng các id ngôn ngữ sẽ được cung cấp dưới dạng đầu vào và sử dụng lớp nhúng id ngôn ngữ. - speaker_embed_dim (
int, tùy chọn) — Kích thước của speaker embedding. Nếu được đặt thành > 0, giả định rằng speaker_embedding sẽ được cung cấp dưới dạng đầu vào. - convolution_bias (
bool, tùy chọn, mặc định làTrue) — Chỉ định việc có sử dụng bias trong các phép convolution của module convolution trong conformer hay không.
Đây là lớp cấu hình để lưu trữ cấu hình của một FastSpeech2ConformerModel. Nó được sử dụng để khởi tạo một mô hình Fastspeech2 Conformer theo các đối số được chỉ định, xác định kiến trúc mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của espnet/fastspeech2_conformer
Các đối tượng cấu hình kế thừa từ PreTrainedConfig và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ PreTrainedConfig để biết thêm thông tin.
Ví dụ:
>>> from transformers import FastSpeech2ConformerModel, FastSpeech2ConformerConfig

>>> # Initializing a FastSpeech2Conformer style configuration
>>> configuration = FastSpeech2ConformerConfig()

>>> # Initializing a model from the FastSpeech2Conformer style configuration
>>> model = FastSpeech2ConformerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerHifiGanConfig
lớp transformers.FastSpeech2ConformerHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_in_dim: int = 80upsample_initial_channel: int = 512upsample_rates: list[int] | tuple[int, ...] = (8, 8, 2, 2)upsample_kernel_sizes: list[int] | tuple[int, ...] = (16, 16, 4, 4)resblock_kernel_sizes: list[int] | tuple[int, ...] = (3, 7, 11)resblock_dilation_sizes: list | tuple | None = Noneinitializer_range: float = 0.01leaky_relu_slope: float = 0.1normalize_before: bool = True )
Tham số
- model_in_dim (
int, tùy chọn, mặc định là 80) — Số lượng bin tần số trong phổ log-mel đầu vào. - upsample_initial_channel (
int, tùy chọn, mặc định là 512) — Số lượng kênh đầu vào của mạng upsampling. - upsample_rates (
tuple[int]hoặclist[int], tùy chọn, mặc định là[8, 8, 2, 2]) — Một tuple các số nguyên xác định stride của mỗi lớp tích chập 1D trong mạng upsampling. Độ dài của upsample_rates xác định số lượng lớp tích chập và phải khớp với độ dài của upsample_kernel_sizes. - upsample_kernel_sizes (
tuple[int]hoặclist[int], tùy chọn, mặc định là[16, 16, 4, 4]) — Một tuple các số nguyên xác định kích thước kernel của từng lớp tích chập 1D trong mạng upsampling. Độ dài của upsample_kernel_sizes xác định số lượng lớp tích chập và phải khớp với độ dài của upsample_rates. - resblock_kernel_sizes (
tuple[int]hoặclist[int], tùy chọn, mặc định là[3, 7, 11]) — Một tuple các số nguyên xác định kích thước kernel của các lớp tích chập 1D trong module fusion trường nhận (MRF). - resblock_dilation_sizes (
tuple[tuple[int]]hoặclist[list[int]], không bắt buộc, mặc định là[[1, 3, 5], [1, 3, 5], [1, 3, 5]]) — Một tuple lồng nhau của các số nguyên định nghĩa tỷ lệ giãn nở của các lớp tích chập 1D giãn nở trong module kết hợp trường nhận đa (MRF). - initializer_range (
float, tùy chọn, mặc định là0.01) — Độ lệch chuẩn của truncated_normal_initializer để khởi tạo tất cả các ma trận trọng số. - leaky_relu_slope (
float, tùy chọn, mặc định là 0.1) — Góc của độ dốc âm được sử dụng bởi hàm kích hoạt leaky ReLU. - normalize_before (
bool, tùy chọn, mặc định làTrue) — Có nên chuẩn hóa phổ âm (spectrogram) trước khi vocoding bằng cách sử dụng trung bình và phương sai đã học của vocoder hay không.
Đây là lớp cấu hình để lưu trữ cấu hình của một FastSpeech2ConformerModel. Nó được sử dụng để khởi tạo một mô hình Fastspeech2 Conformer theo các đối số được chỉ định, xác định kiến trúc mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của espnet/fastspeech2_conformer_with_hifigan
Các đối tượng cấu hình kế thừa từ PreTrainedConfig và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ PreTrainedConfig để biết thêm thông tin.
Ví dụ:
>>> from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerHifiGanConfig

>>> # Initializing a FastSpeech2ConformerHifiGan configuration
>>> configuration = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a model (with random weights) from the configuration
>>> model = FastSpeech2ConformerHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerWithHifiGanConfig
lớp transformers.FastSpeech2ConformerWithHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevocoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None )
Đây là lớp cấu hình để lưu trữ cấu hình của một FastSpeech2ConformerModel. Nó được sử dụng để khởi tạo một mô hình Fastspeech2 Conformer theo các đối số được chỉ định, xác định kiến trúc mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của espnet/fastspeech2_conformer_with_hifigan
Các đối tượng cấu hình kế thừa từ PreTrainedConfig và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ PreTrainedConfig để biết thêm thông tin.
Ví dụ:
>>> from transformers import (
...     FastSpeech2ConformerConfig,
...     FastSpeech2ConformerHifiGanConfig,
...     FastSpeech2ConformerWithHifiGanConfig,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> # Initializing FastSpeech2ConformerWithHifiGan sub-modules configurations.
>>> model_config = FastSpeech2ConformerConfig()
>>> vocoder_config = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a FastSpeech2ConformerWithHifiGan module style configuration
>>> configuration = FastSpeech2ConformerWithHifiGanConfig(model_config.to_dict(), vocoder_config.to_dict())

>>> # Initializing a model (with random weights)
>>> model = FastSpeech2ConformerWithHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerTokenizer
lớp transformers.FastSpeech2ConformerTokenizer
< source >( vocab_filebos_token = '<sos/eos>'eos_token = '<sos/eos>'pad_token = '<blank>'unk_token = '<unk>'should_strip_spaces = False**kwargs )
Tham số
- vocab_file (
str) — Đường dẫn đến tệp từ vựng. - bos_token (
str, tùy chọn, mặc định là"<sos/eos>") — Token bắt đầu chuỗi. Lưu ý rằng đối với FastSpeech2, token này giống vớieos_token. - eos_token (
str, tùy chọn, mặc định là"<sos/eos>") — Token kết thúc chuỗi. Lưu ý rằng đối với FastSpeech2, token này giống vớibos_token. - pad_token (
str, tùy chọn, mặc định là"<blank>") — Token được sử dụng để đệm, chẳng hạn khi xử lý các lô (batch) gồm các chuỗi có độ dài khác nhau. - unk_token (
str, tùy chọn, mặc định là"<unk>") — Token không xác định. Một token không có trong từ vựng sẽ không thể được chuyển đổi thành ID và sẽ được gán thành token này thay thế. - should_strip_spaces (
bool, tùy chọn, mặc định làFalse) — Có nên loại bỏ khoảng trắng khỏi danh sách các token hay không.
Xây dựng một tokenizer FastSpeech2Conformer.
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
Tham số
- text (
str,list[str],list[list[str]], tùy chọn) — Chuỗi hoặc lô các chuỗi cần được mã hóa. Mỗi chuỗi có thể là một chuỗi ký tự hoặc một danh sách các chuỗi ký tự (chuỗi đã được tiền mã hóa). Nếu các chuỗi được cung cấp dưới dạng danh sách các chuỗi ký tự (tiền mã hóa), bạn phải đặtis_split_into_words=True(để loại bỏ sự mơ hồ với một lô các chuỗi). - text_pair (
str,list[str],list[list[str]], tùy chọn) — Chuỗi hoặc lô các chuỗi cần được mã hóa. Mỗi chuỗi có thể là một chuỗi ký tự hoặc một danh sách các chuỗi ký tự (chuỗi đã được tách token trước). Nếu các chuỗi được cung cấp dưới dạng danh sách các chuỗi ký tự (đã tách token trước), bạn phải đặtis_split_into_words=True(để loại bỏ sự mơ hồ với một lô các chuỗi). - text_target (
str,list[str],list[list[str]], tùy chọn) — Chuỗi hoặc lô các chuỗi cần được mã hóa dưới dạng văn bản đích. Mỗi chuỗi có thể là một chuỗi ký tự hoặc một danh sách các chuỗi ký tự (chuỗi đã tách token). Nếu các chuỗi được cung cấp dưới dạng danh sách các chuỗi ký tự (đã tách token), bạn phải đặtis_split_into_words=True(để loại bỏ sự mơ hồ với một lô các chuỗi). - text_pair_target (
str,list[str],list[list[str]], tùy chọn) — Chuỗi hoặc lô các chuỗi cần được mã hóa dưới dạng văn bản đích. Mỗi chuỗi có thể là một chuỗi ký tự hoặc một danh sách các chuỗi ký tự (chuỗi đã tách token). Nếu các chuỗi được cung cấp dưới dạng danh sách các chuỗi ký tự (đã tách token), bạn phải đặtis_split_into_words=True(để loại bỏ sự mơ hồ với một lô các chuỗi). - tokenizer_kwargs (
dict[str, Any], tùy chọn) — Các kwargs bổ sung để truyền cho tokenizer. Chúng sẽ được gộp với các tham số tường minh và các kwargs khác, trong đó các tham số tường minh có độ ưu tiên cao hơn. - add_special_tokens (
bool, tùy chọn, mặc định làTrue) — Có thêm các token đặc biệt khi mã hóa các chuỗi hay không. Điều này sẽ sử dụng hàmPretrainedTokenizerBase.build_inputs_with_special_tokensbên dưới, hàm này xác định các token nào được thêm tự động vào các id đầu vào. Điều này hữu ích nếu bạn muốn thêm các tokenboshoặceosmột cách tự động. - padding (
bool,strhoặc PaddingStrategy, tùy chọn, mặc định làFalse) — Kích hoạt và kiểm soát padding. Chấp nhận các giá trị sau:Truehoặc'longest': Lấp đầy (pad) đến độ dài của chuỗi dài nhất trong batch (hoặc không lấp đầy nếu chỉ cung cấp một chuỗi duy nhất).'max_length': Đệm (pad) đến độ dài tối đa được chỉ định bằng tham sốmax_lengthhoặc đến độ dài đầu vào tối đa mà mô hình chấp nhận được nếu tham số đó không được cung cấp.Falsehoặc'do_not_pad'(mặc định): Không đệm (tức là có thể xuất ra một lô với các chuỗi có độ dài khác nhau).
- truncation (
bool,strhoặc TruncationStrategy, tùy chọn, mặc định làFalse) — Kích hoạt và kiểm soát việc cắt ngắn. Chấp nhận các giá trị sau:Truehoặc'longest_first': Cắt ngắn xuống độ dài tối đa được chỉ định bằng tham sốmax_lengthhoặc xuống độ dài đầu vào tối đa chấp nhận được của mô hình nếu tham số đó không được cung cấp. Thao tác này sẽ cắt ngắn theo từng token, loại bỏ một token từ chuỗi dài nhất trong cặp nếu một cặp chuỗi (hoặc một lô các cặp) được cung cấp.'only_first': Cắt ngắn xuống độ dài tối đa được chỉ định bằng tham sốmax_lengthhoặc xuống độ dài đầu vào tối đa mà mô hình chấp nhận được nếu tham số đó không được cung cấp. Thao tác này chỉ cắt ngắn chuỗi đầu tiên của một cặp nếu một cặp chuỗi (hoặc một lô các cặp) được cung cấp.'only_second': Cắt ngắn xuống độ dài tối đa được chỉ định bằng tham sốmax_lengthhoặc xuống độ dài đầu vào tối đa mà mô hình chấp nhận được nếu tham số đó không được cung cấp. Thao tác này chỉ cắt ngắn chuỗi thứ hai của một cặp nếu một cặp chuỗi (hoặc một lô các cặp) được cung cấp.Falsehoặc'do_not_truncate'(mặc định): Không cắt bớt (tức là có thể xuất ra batch với độ dài chuỗi lớn hơn kích thước đầu vào tối đa cho phép của mô hình).
- max_length (
int, tuỳ chọn) — Kiểm soát độ dài tối đa được sử dụng bởi một trong các tham số cắt/giữ chỗ (truncation/padding).Nếu không được đặt hoặc được đặt thành
None, tham số này sẽ sử dụng độ dài tối đa định trước của mô hình nếu một trong các tham số cắt/giữ chỗ yêu cầu độ dài tối đa. Nếu mô hình không có độ dài đầu vào tối đa cụ thể (như XLNet), việc cắt/giữ chỗ đến độ dài tối đa sẽ bị vô hiệu hóa. - stride (
int, tùy chọn, mặc định là 0) — Nếu được đặt thành một số cùng vớimax_length, các token tràn ra được trả về khireturn_overflowing_tokens=Truesẽ chứa một số token từ cuối của chuỗi bị cắt ngắn được trả về để tạo ra một phần chồng lấn giữa các chuỗi bị cắt ngắn và các chuỗi tràn ra. Giá trị của đối số này xác định số lượng token chồng lấn. - is_split_into_words (
bool, tùy chọn, mặc định làFalse) — Cho biết đầu vào đã được tiền xử lý token hay chưa (ví dụ: đã tách thành các từ). Nếu đặt thànhTrue, bộ phân tích token sẽ giả định rằng đầu vào đã được tách thành các từ (chẳng hạn, bằng cách tách theo khoảng trắng) và sẽ tiến hành phân tích token cho chúng. Điều này hữu ích cho NER hoặc phân loại token. - pad_to_multiple_of (
int, tùy chọn) — Nếu được đặt, chuỗi sẽ được đệm đến một bội số của giá trị được cung cấp. Yêu cầupaddingphải được kích hoạt. Điều này đặc biệt hữu ích để cho phép sử dụng Tensor Cores trên phần cứng NVIDIA có khả năng tính toán>= 7.5(Volta). - padding_side (
str, tùy chọn) — Bên mà mô hình cần được áp dụng padding. Nên chọn giữa [‘right’, ‘left’]. Giá trị mặc định được lấy từ thuộc tính lớp có cùng tên. - return_tensors (
strhoặc TensorType, tùy chọn) — Nếu được đặt, sẽ trả về tensor thay vì danh sách các số nguyên Python. Các giá trị chấp nhận được là:'pt': Trả về các đối tượngtorch.Tensorcủa PyTorch.'np': Trả về các đối tượng Numpynp.ndarray.
- return_token_type_ids (
bool, tuỳ chọn) — Có trả về token type IDs hay không. Nếu để mặc định, sẽ trả về token type IDs theo mặc định của tokenizer cụ thể, được xác định bởi thuộc tínhreturn_outputs. - return_attention_mask (
bool, tuỳ chọn) — Có trả về attention mask hay không. Nếu để mặc định, sẽ trả về attention mask theo mặc định của tokenizer cụ thể, được xác định bởi thuộc tínhreturn_outputs. - return_overflowing_tokens (
bool, tùy chọn, mặc định làFalse) — Có trả về các chuỗi token tràn hay không. Nếu một cặp chuỗi input ids (hoặc một batch các cặp) được cung cấp vớitruncation_strategy = longest_firsthoặcTrue, một lỗi sẽ được ném thay vì trả về các token tràn. - return_special_tokens_mask (
bool, tùy chọn, mặc định làFalse) — Có trả về thông tin mặt nạ (mask) cho các token đặc biệt hay không. - return_offsets_mapping (
bool, tuỳ chọn, mặc định làFalse) — Có trả về(char_start, char_end)cho từng token hay không.Tính năng này chỉ khả dụng trên các bộ phân từ nhanh kế thừa từ PreTrainedTokenizerFast; nếu sử dụng bộ phân từ của Python, phương thức này sẽ gây ra
NotImplementedError. - return_length (
bool, tùy chọn, mặc định làFalse) — Có trả về độ dài của các đầu vào đã mã hóa hay không. - verbose (
bool, tùy chọn, mặc định làTrue) — Có in thêm thông tin và cảnh báo hay không. - **kwargs — được truyền đến phương thức
self.tokenize()
Trả về
Một BatchEncoding với các trường sau:
-
input_ids — Danh sách các id token để đưa vào mô hình.
-
token_type_ids — Danh sách các id loại token để đưa vào mô hình (khi
return_token_type_ids=Truehoặc nếu “token_type_ids” nằm trongself.model_input_names). -
attention_mask — Danh sách các chỉ số chỉ định những token nào nên được mô hình chú ý đến (khi
return_attention_mask=Truehoặc nếu “attention_mask” nằm trongself.model_input_names). -
overflowing_tokens — Danh sách các chuỗi token bị tràn (khi
max_lengthđược chỉ định vàreturn_overflowing_tokens=True). -
num_truncated_tokens — Số lượng token bị cắt bỏ (khi có chỉ định
max_lengthvàreturn_overflowing_tokens=True). -
special_tokens_mask — Danh sách các số 0 và 1, trong đó 1 chỉ định các token đặc biệt được thêm vào và 0 chỉ định các token chuỗi thông thường (khi
add_special_tokens=Truevàreturn_special_tokens_mask=True). -
length — Độ dài của các đầu vào (khi
return_length=True)
Phương thức chính để mã hóa token và chuẩn bị cho mô hình một hoặc nhiều chuỗi, hoặc một hoặc nhiều cặp chuỗi.
save_vocabulary
< source >( save_directory: strfilename_prefix: str | None = None ) → Tuple(str)
Lưu tệp từ vựng và các token đặc biệt vào một thư mục.
batch_decode
< source >( sequences: list[int] | list[list[int]] | np.ndarray | torch.Tensorskip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = None**kwargs ) → list[str]
Tham số
- sequences (
Union[list[int], list[list[int]], np.ndarray, torch.Tensor]) — Danh sách các id đầu vào đã được token hóa. Có thể lấy được bằng cách sử dụng phương thức__call__. - skip_special_tokens (
bool, tùy chọn, mặc định làFalse) — Có loại bỏ các token đặc biệt trong quá trình giải mã hay không. - clean_up_tokenization_spaces (
bool, tùy chọn) — Có dọn dẹp khoảng trắng token hóa hay không. Nếu làNone, mặc định sẽ làself.clean_up_tokenization_spaces. - kwargs (các tham số từ khóa bổ sung, tùy chọn) — Sẽ được truyền đến phương thức decode cụ thể của model bên dưới.
Trả về
list[str]
Danh sách các câu đã giải mã.
Chuyển đổi một danh sách các danh sách id token thành một danh sách các chuỗi bằng cách gọi decode.
Phương pháp này được cung cấp để đảm bảo tương thích ngược. Phương pháp decode hiện xử lý đầu vào dạng lô (batched) một cách bản địa,
do đó bạn có thể sử dụng trực tiếp decode thay vì batch_decode.
FastSpeech2ConformerModel
lớp transformers.FastSpeech2ConformerModel
< source >( config: FastSpeech2ConformerConfig )
Tham số
- config (FastSpeech2ConformerConfig) — Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức from_pretrained() để tải trọng số mô hình.
Mô hình FastSpeech2Conformer.
Mô hình này kế thừa từ PreTrainedModel. Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu, v.v.)
Mô hình này cũng là một lớp con của torch.nn.Module trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
Tham số
- input_ids (
torch.LongTensorcó hình dạng(batch_size, sequence_length)) — Chuỗi đầu vào của các vector văn bản. - attention_mask (
torch.LongTensorcó hình dạng(batch_size, sequence_length), tùy chọn) — Mặt nạ để tránh thực hiện attention trên các chỉ số token padding. Các giá trị mặt nạ được chọn trong[0, 1]:- 1 cho các token không bị che,
- 0 cho các token bị che.
- spectrogram_labels (
torch.Tensorcó hình dạng(batch_size, max_spectrogram_length, num_mel_bins), tùy chọn, mặc định làNone) — Batch các đặc trưng đích đã được đệm (padded). - duration_labels (
torch.LongTensorcó hình dạng(batch_size, sequence_length + 1), tùy chọn, mặc định làNone) — Batch các duration đã được đệm (padded). - pitch_labels (
torch.Tensorcó shape(batch_size, sequence_length + 1, 1), tùy chọn, mặc định làNone) — Batch chứa pitch trung bình theo token đã được pad. - energy_labels (
torch.Tensorcó hình dạng(batch_size, sequence_length + 1, 1), tùy chọn, mặc định làNone) — Batch các giá trị năng lượng trung bình theo token đã được đệm (padded). - speaker_ids (
torch.LongTensorcó hình dạng(batch_size, 1), tùy chọn, mặc định làNone) — Các id người nói được sử dụng để điều kiện hóa các đặc trưng của đầu ra giọng nói bởi mô hình. - lang_ids (
torch.LongTensorcó hình dạng(batch_size, 1), tùy chọn, mặc định làNone) — Các id ngôn ngữ được sử dụng để điều kiện hóa các đặc trưng của đầu ra giọng nói bởi mô hình. - speaker_embedding (
torch.Tensorcó hình dạng(batch_size, embedding_dim), tùy chọn, mặc định làNone) — Embedding chứa các tín hiệu điều kiện cho các đặc trưng của giọng nói. - return_dict (
bool, tùy chọn) — Có nên trả về một ModelOutput thay vì một tuple thông thường hay không. - output_attentions (
bool, tùy chọn) — Có trả về các tensor attentions của tất cả các lớp attention hay không. Xemattentionstrong phần tensor được trả về để biết thêm chi tiết. - output_hidden_states (
bool, tùy chọn) — Có trả về trạng thái ẩn (hidden states) của tất cả các lớp hay không. Xemhidden_statestrong phần tensor trả về để biết thêm chi tiết.
Trả về
FastSpeech2ConformerModelOutput hoặc tuple(torch.Tensor)
Một FastSpeech2ConformerModelOutput hoặc một tuple của
torch.Tensor (nếu return_dict=False được truyền hoặc khi config.return_dict=False) bao gồm các
thành phần khác nhau tùy thuộc vào cấu hình (FastSpeech2ConformerConfig) và đầu vào.
Phương thức forward của FastSpeech2ConformerModel ghi đè lên phương thức đặc biệt __call__.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, người dùng nên gọi instance của
Modulesau đó thay vì gọi hàm này, vì instanceModulesẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ lặng lẽ bỏ qua chúng.
loss (
torch.Tensorcó hình dạng(1,), tùy chọn, được trả về khilabelsđược cung cấp) — Tổn thất tạo phổ âm (spectrogram).spectrogram (
torch.Tensorcó hình dạng(batch_size, sequence_length, num_bins), tùy chọn) — Phổ âm thanh dự đoán.encoder_last_hidden_state (
torch.Tensorcó hình dạng(batch_size, sequence_length, hidden_size), tùy chọn) — Chuỗi các trạng thái ẩn tại đầu ra của lớp cuối cùng của bộ mã hóa trong mô hình.encoder_hidden_states (
tuple[torch.Tensor], tuỳ chọn, được trả về khioutput_hidden_states=Trueđược truyền vào hoặc khiconfig.output_hidden_states=True) — Bộ tuple cáctorch.Tensor(một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng(batch_size, sequence_length, hidden_size).Trạng thái ẩn của bộ mã hóa tại đầu ra của mỗi lớp cùng với đầu ra của nhúng ban đầu.
encoder_attentions (
tuple[torch.Tensor], tuỳ chọn, được trả về khioutput_attentions=Trueđược truyền vào hoặc khiconfig.output_attentions=True) — Bộ tuple củatorch.Tensor(một cho mỗi lớp) có hình dạng(batch_size, num_heads, sequence_length, sequence_length).Trọng số chú ý của bộ mã hóa, sau softmax chú ý, được sử dụng để tính trung bình có trọng số trong các đầu chú ý tự (self-attention).
decoder_hidden_states (
tuple[torch.Tensor], tuỳ chọn, được trả về khioutput_hidden_states=Trueđược truyền vào hoặc khiconfig.output_hidden_states=True) — Tuple củatorch.Tensor(một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng(batch_size, sequence_length, hidden_size).Trạng thái ẩn của bộ giải mã tại đầu ra của mỗi lớp cùng với đầu ra của nhúng ban đầu.
decoder_attentions (
tuple[torch.Tensor], tùy chọn, được trả về khioutput_attentions=Trueđược truyền vào hoặc khiconfig.output_attentions=True) — Tuple củatorch.Tensor(một cho mỗi lớp) có hình dạng(batch_size, num_heads, sequence_length, sequence_length).Trọng số chú ý của bộ giải mã, sau softmax chú ý, được sử dụng để tính trung bình có trọng số trong các đầu chú ý tự (self-attention).
duration_outputs (
torch.LongTensorcó hình dạng(batch_size, max_text_length + 1), tùy chọn) — Đầu ra của bộ dự đoán thời lượng.pitch_outputs (
torch.Tensorcó hình dạng(batch_size, max_text_length + 1, 1), tùy chọn) — Đầu ra của bộ dự đoán cao độ.energy_outputs (
torch.Tensorcó hình dạng(batch_size, max_text_length + 1, 1), tùy chọn) — Đầu ra của bộ dự đoán năng lượng.
Ví dụ:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerModel,
...     FastSpeech2ConformerHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer")
>>> output_dict = model(input_ids, return_dict=True)
>>> spectrogram = output_dict["spectrogram"]

>>> vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
>>> waveform = vocoder(spectrogram)
>>> print(waveform.shape)
torch.Size([1, 49664])
FastSpeech2ConformerHifiGan
lớp transformers.FastSpeech2ConformerHifiGan
< source >( config: FastSpeech2ConformerHifiGanConfig )
Tham số
- config (FastSpeech2ConformerHifiGanConfig) — Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức from_pretrained() để tải trọng số của mô hình.
Vocoder HiFi-GAN.
Mô hình này kế thừa từ PreTrainedModel. Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu, v.v.)
Mô hình này cũng là một lớp con của torch.nn.Module trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
forward
< source >( spectrogram: Tensor**kwargs ) → torch.Tensor
Tham số
- spectrogram (
torch.Tensor) — Tensor chứa các spectrogram log-mel. Có thể được batch và có shape(batch_size, sequence_length, config.model_in_dim), hoặc không batch và có shape(sequence_length, config.model_in_dim).
Trả về
torch.Tensor
Tensor chứa dạng sóng âm thanh. Nếu phổ đồ đầu vào được nhóm (batched), sẽ có hình dạng (batch_size, num_frames,). Nếu không nhóm, sẽ có hình dạng (num_frames,).
Chuyển đổi phổ log-mel thành dạng sóng âm thanh. Truyền vào một lô (batch) các phổ log-mel sẽ trả về một lô các dạng sóng âm thanh. Truyền vào một phổ log-mel đơn lẻ, không nằm trong lô, sẽ trả về một dạng sóng âm thanh đơn lẻ, không nằm trong lô.
FastSpeech2ConformerWithHifiGan
lớp transformers.FastSpeech2ConformerWithHifiGan
< source >( config: FastSpeech2ConformerWithHifiGanConfig )
Tham số
- config (FastSpeech2ConformerWithHifiGanConfig) — Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức from_pretrained() để tải trọng số của mô hình.
The FastSpeech2ConformerModel với đầu vocoder FastSpeech2ConformerHifiGan thực hiện chuyển văn bản thành giọng nói (waveform).
Mô hình này kế thừa từ PreTrainedModel. Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu, v.v.)
Mô hình này cũng là một lớp con của torch.nn.Module trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
Tham số
- input_ids (
torch.LongTensorcó hình dạng(batch_size, sequence_length)) — Chuỗi đầu vào của các vector văn bản. - attention_mask (
torch.LongTensorcó hình dạng(batch_size, sequence_length), tùy chọn) — Mặt nạ để tránh thực hiện attention trên các chỉ số token padding. Các giá trị mặt nạ được chọn trong[0, 1]:- 1 cho các token không bị che,
- 0 cho các token bị che.
- spectrogram_labels (
torch.Tensorcó hình dạng(batch_size, max_spectrogram_length, num_mel_bins), tùy chọn, mặc định làNone) — Batch các đặc trưng đích đã được đệm (padded). - duration_labels (
torch.LongTensorcó hình dạng(batch_size, sequence_length + 1), tùy chọn, mặc định làNone) — Batch các duration đã được đệm (padded). - pitch_labels (
torch.Tensorcó shape(batch_size, sequence_length + 1, 1), tùy chọn, mặc định làNone) — Batch chứa pitch trung bình theo token đã được pad. - energy_labels (
torch.Tensorcó hình dạng(batch_size, sequence_length + 1, 1), tùy chọn, mặc định làNone) — Batch các giá trị năng lượng trung bình theo token đã được đệm (padded). - speaker_ids (
torch.LongTensorcó hình dạng(batch_size, 1), tùy chọn, mặc định làNone) — Các id người nói được sử dụng để điều kiện hóa các đặc trưng của đầu ra giọng nói bởi mô hình. - lang_ids (
torch.LongTensorcó hình dạng(batch_size, 1), tùy chọn, mặc định làNone) — Các id ngôn ngữ được sử dụng để điều kiện hóa các đặc trưng của đầu ra giọng nói bởi mô hình. - speaker_embedding (
torch.Tensorcó hình dạng(batch_size, embedding_dim), tùy chọn, mặc định làNone) — Embedding chứa các tín hiệu điều kiện cho các đặc trưng của giọng nói. - return_dict (
bool, tùy chọn) — Có nên trả về một ModelOutput thay vì một tuple thông thường hay không. - output_attentions (
bool, tùy chọn) — Có trả về các tensor attentions của tất cả các lớp attention hay không. Xemattentionstrong phần tensor được trả về để biết thêm chi tiết. - output_hidden_states (
bool, tùy chọn) — Có trả về trạng thái ẩn (hidden states) của tất cả các lớp hay không. Xemhidden_statestrong phần tensor trả về để biết thêm chi tiết.
Trả về
FastSpeech2ConformerModelOutput hoặc tuple(torch.Tensor)
Một FastSpeech2ConformerModelOutput hoặc một tuple của
torch.Tensor (nếu return_dict=False được truyền hoặc khi config.return_dict=False) bao gồm các
thành phần khác nhau tùy thuộc vào cấu hình (FastSpeech2ConformerConfig) và đầu vào.
Phương thức forward của FastSpeech2ConformerWithHifiGan ghi đè lên phương thức đặc biệt __call__.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, người dùng nên gọi instance của
Modulesau đó thay vì gọi hàm này, vì instanceModulesẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ lặng lẽ bỏ qua chúng.
loss (
torch.Tensorcó hình dạng(1,), tùy chọn, được trả về khilabelsđược cung cấp) — Tổn thất tạo phổ âm (spectrogram).spectrogram (
torch.Tensorcó hình dạng(batch_size, sequence_length, num_bins), tùy chọn) — Phổ âm thanh dự đoán.encoder_last_hidden_state (
torch.Tensorcó hình dạng(batch_size, sequence_length, hidden_size), tùy chọn) — Chuỗi các trạng thái ẩn tại đầu ra của lớp cuối cùng của bộ mã hóa trong mô hình.encoder_hidden_states (
tuple[torch.Tensor], tuỳ chọn, được trả về khioutput_hidden_states=Trueđược truyền vào hoặc khiconfig.output_hidden_states=True) — Bộ tuple cáctorch.Tensor(một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng(batch_size, sequence_length, hidden_size).Trạng thái ẩn của bộ mã hóa tại đầu ra của mỗi lớp cùng với đầu ra của nhúng ban đầu.
encoder_attentions (
tuple[torch.Tensor], tuỳ chọn, được trả về khioutput_attentions=Trueđược truyền vào hoặc khiconfig.output_attentions=True) — Bộ tuple củatorch.Tensor(một cho mỗi lớp) có hình dạng(batch_size, num_heads, sequence_length, sequence_length).Trọng số chú ý của bộ mã hóa, sau softmax chú ý, được sử dụng để tính trung bình có trọng số trong các đầu chú ý tự (self-attention).
decoder_hidden_states (
tuple[torch.Tensor], tuỳ chọn, được trả về khioutput_hidden_states=Trueđược truyền vào hoặc khiconfig.output_hidden_states=True) — Tuple củatorch.Tensor(một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng(batch_size, sequence_length, hidden_size).Trạng thái ẩn của bộ giải mã tại đầu ra của mỗi lớp cùng với đầu ra của nhúng ban đầu.
decoder_attentions (
tuple[torch.Tensor], tùy chọn, được trả về khioutput_attentions=Trueđược truyền vào hoặc khiconfig.output_attentions=True) — Tuple củatorch.Tensor(một cho mỗi lớp) có hình dạng(batch_size, num_heads, sequence_length, sequence_length).Trọng số chú ý của bộ giải mã, sau softmax chú ý, được sử dụng để tính trung bình có trọng số trong các đầu chú ý tự (self-attention).
duration_outputs (
torch.LongTensorcó hình dạng(batch_size, max_text_length + 1), tùy chọn) — Đầu ra của bộ dự đoán thời lượng.pitch_outputs (
torch.Tensorcó hình dạng(batch_size, max_text_length + 1, 1), tùy chọn) — Đầu ra của bộ dự đoán cao độ.energy_outputs (
torch.Tensorcó hình dạng(batch_size, max_text_length + 1, 1), tùy chọn) — Đầu ra của bộ dự đoán năng lượng.
Ví dụ:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
>>> output_dict = model(input_ids, return_dict=True)
>>> waveform = output_dict["waveform"]
>>> print(waveform.shape)
torch.Size([1, 49664])