
Transformers documentation
ViTMAE
Эта модель была опубликована в HF papers 11.11.2021 и добавлена в Hugging Face Transformers 18.01.2022.


ViTMAE
ViTMAE — это модель компьютерного зрения, обучаемая в режиме самообучения, которая предварительно обучается путём маскирования значительной части изображения (~75%). Кодер обрабатывает видимые фрагменты изображения, а декодер восстанавливает отсутствующие пиксели на основе закодированных фрагментов и токенов маски. После предварительного обучения кодер можно повторно использовать для задач, следующих за ним, таких как классификация изображений или обнаружение объектов, — часто он превосходит по качеству модели, обученные с учителем.
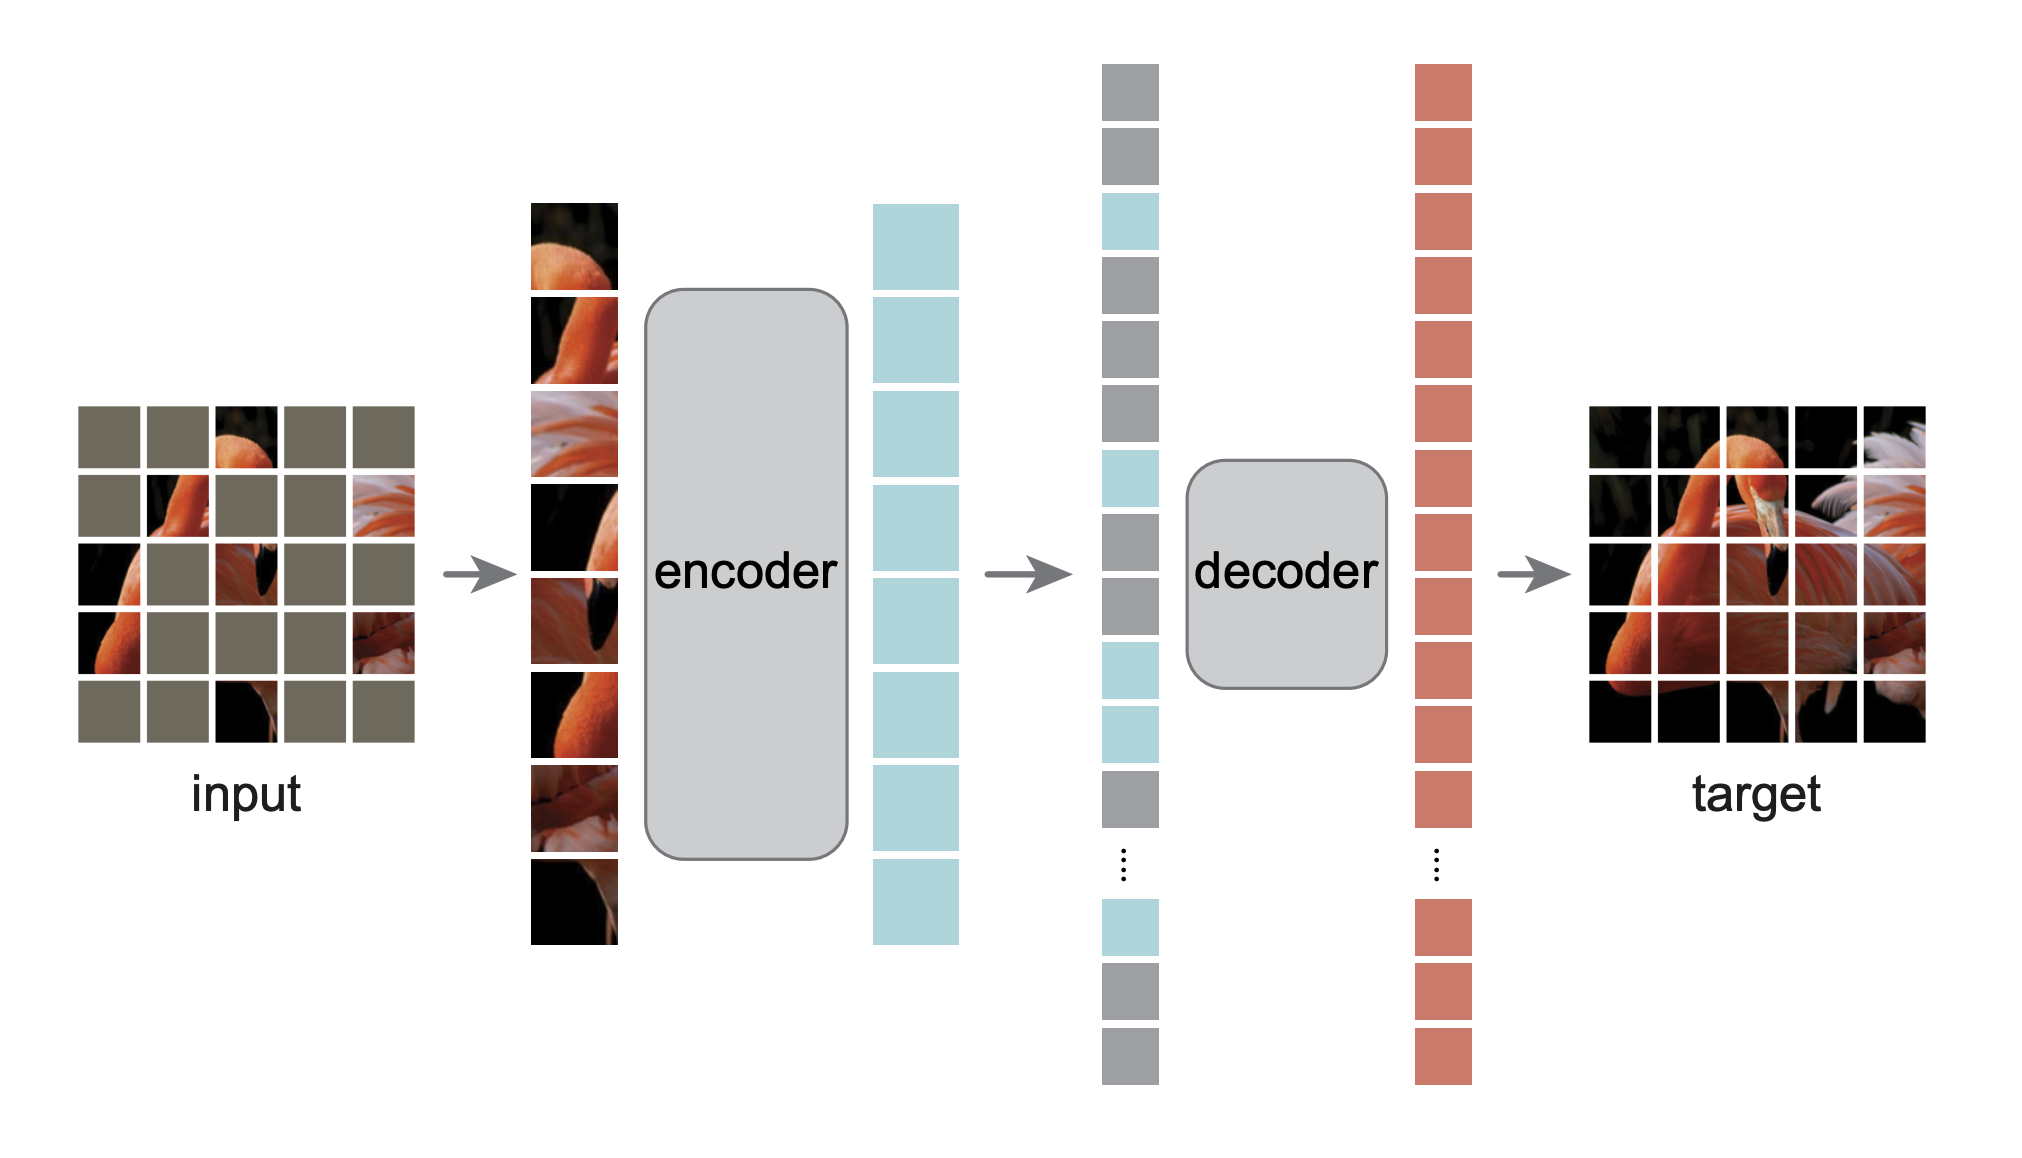
Все исходные контрольные точки ViTMAE можно найти в организации AI at Meta.
Щёлкните по моделям ViTMAE в боковой панели справа, чтобы увидеть больше примеров применения ViTMAE к задачам компьютерного зрения.
Приведённый ниже пример демонстрирует, как восстановить отсутствующие пиксели с помощью класса ViTMAEForPreTraining.
import requests
import torch
from PIL import Image

from transformers import ViTImageProcessor, ViTMAEForPreTraining


url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)

processor = ViTImageProcessor.from_pretrained("facebook/vit-mae-base")
inputs = processor(image, return_tensors="pt").to(model.device)
inputs = {k: v.to(model.device) for k, v in inputs.items()}

model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base", attn_implementation="sdpa", device_map="auto")
with torch.no_grad():
    outputs = model(**inputs)

reconstruction = outputs.logits
Примечания
- ViTMAE обычно используется в два этапа. Сначала выполняется самообучение с помощью ViTMAEForPreTraining, затем декодер отбрасывается, а энкодер дообучается. После дообучения веса можно подключить к модели, например ViTForImageClassification.
- Используйте ViTImageProcessor для подготовки входных данных.
Ресурсы
- См. этот ноутбук, чтобы узнать, как визуализировать восстановленные пиксели из ViTMAEForPreTraining.
ViTMAEConfig
класс transformers.ViTMAEConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.0attention_probs_dropout_prob: float | int = 0.0initializer_range: float = 0.02layer_norm_eps: float = 1e-12image_size: int | list[int] | tuple[int, int] = 224patch_size: int | list[int] | tuple[int, int] = 16num_channels: int = 3qkv_bias: bool = Truedecoder_num_attention_heads: int = 16decoder_hidden_size: int = 512decoder_num_hidden_layers: int = 8decoder_intermediate_size: int = 2048mask_ratio: float = 0.75norm_pix_loss: bool = False )
Параметры
- hidden_size (
int, необязательный, по умолчанию768) — Размерность скрытых представлений. - num_hidden_layers (
int, необязательный, по умолчанию12) — Количество скрытых слоев в декодере Transformer. - num_attention_heads (
int, необязательный, по умолчанию12) — Количество головок внимания в каждом слое внимания декодера Transformer. - intermediate_size (
int, необязательный, по умолчанию3072) — Размерность представлений MLP. - hidden_act (
str, необязательный, по умолчаниюgelu) — Нелинейная функция активации (функция или строка) в декодере. Например,"gelu","relu","silu"и т. д. - hidden_dropout_prob (
Union[float, int], необязательный, по умолчанию0.0) — Вероятность dropout для всех полносвязных слоёв в блоках эмбеддингов, энкодера и пуллера. - attention_probs_dropout_prob (
Union[float, int], необязательный, по умолчанию0.0) — Коэффициент dropout для вероятностей внимания. - initializer_range (
float, необязательный, по умолчанию0.02) — Стандартное отклонение truncated_normal_initializer, используемое для инициализации всех матриц весов. - layer_norm_eps (
float, необязательный, по умолчанию1e-12) — Значение epsilon, используемое слоями нормализации. - image_size (
Union[int, list[int], tuple[int, int]], необязательный, по умолчанию224) — Размер (разрешение) каждого изображения. - patch_size (
Union[int, list[int], tuple[int, int]], необязательный, по умолчанию16) — Размер (разрешение) каждого патча. - num_channels (
int, необязательный, по умолчанию3) — Количество входных каналов. - qkv_bias (
bool, необязательный, по умолчаниюTrue) — Добавлять ли смещение к запросам, ключам и значениям. - decoder_num_attention_heads (
int, необязательный, по умолчанию16) — Количество головок внимания в каждом слое внимания декодера Transformer. - decoder_hidden_size (
int, необязательный, по умолчанию512) — Размерность скрытых представлений. - decoder_num_hidden_layers (
int, необязательный, по умолчанию 8) — Количество скрытых слоев в декодере. - decoder_intermediate_size (
int, необязательный, по умолчанию2048) — Размерность представлений MLP. - mask_ratio (
float, необязательный, по умолчанию 0.75) — Доля замаскированных токенов во входной последовательности. - norm_pix_loss (
bool, необязательный, по умолчаниюFalse) — Указывает, следует ли обучать модель с нормализованными пикселями (см. таблицу 3 в статье). Использование нормализованных пикселей повышало качество представления в экспериментах авторов.
Это класс конфигурации для хранения настроек модели ViTMAEModel. Он используется для создания модели Vit Mae в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации facebook/vit-mae-base
Объекты конфигурации наследуются от PreTrainedConfig и могут использоваться для управления выводами модели. Подробнее читайте в документации PreTrainedConfig.
Пример:
>>> from transformers import ViTMAEConfig, ViTMAEModel

>>> # Initializing a ViT MAE vit-mae-base style configuration
>>> configuration = ViTMAEConfig()

>>> # Initializing a model (with random weights) from the vit-mae-base style configuration
>>> model = ViTMAEModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
ViTMAEModel
класс transformers.ViTMAEModel
< source >( config: ViTMAEConfig )
Параметры
- config (ViTMAEConfig) — Конфигурация модели.
Модель Vit Mae без дополнительных слоёв, выводящая необработанные скрытые состояния.
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonenoise: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool | None = Noneattention_mask: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → ViTMAEModelOutput or tuple(torch.Tensor)
Параметры
- pixel_values (
torch.Tensorформы(batch_size, num_channels, image_size, image_size), необязательный) — Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью ViTImageProcessor. Подробности см. в ViTImageProcessor.call() (processor_classиспользует ViTImageProcessor для обработки изображений). - noise (
torch.Tensorформы(batch_size, sequence_length), необязательный) — Используется в основном для тестирования, чтобы контролировать случайность и обеспечивать воспроизводимость - interpolate_pos_encoding (
bool, необязательный, по умолчаниюFalse) — Указывает, следует ли интерполировать предобученные позиционные кодировки. Это в основном используется для применения модели к изображениям с более высоким разрешением. - attention_mask (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения токенов-заполнителей из внимания. Значения маски из диапазона[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
Возвращает
ViTMAEModelOutput или tuple(torch.Tensor)
ViTMAEModelOutput или кортеж из
torch.Tensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (ViTMAEConfig) и входных данных.
Метод forward модели ViTMAEModel переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
last_hidden_state (
torch.Tensorформы(batch_size, sequence_length, hidden_size), необязательный) — Последовательность скрытых состояний на выходе последнего слоя модели.mask (
torch.Tensorформы(batch_size, sequence_length)) — тензор, указывающий, какие патчи замаскированы (1), а какие нет (0).ids_restore (
torch.LongTensorформы(batch_size, sequence_length)) — тензор, содержащий исходные индексы (перемешанных) замаскированных патчей.hidden_states (
tuple[torch.Tensor], необязательный, возвращается при передачеoutput_hidden_states=Trueили когдаconfig.output_hidden_states=True) — Кортеж изtorch.Tensor(один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
attentions (
tuple[torch.Tensor], необязательный, возвращается при передачеoutput_attentions=Trueили когдаconfig.output_attentions=True) — Кортежtorch.Tensor(по одному на каждый слой) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
>>> from transformers import AutoImageProcessor, ViTMAEModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEModel.from_pretrained("facebook/vit-mae-base")

>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
ViTMAEForPreTraining
класс transformers.ViTMAEForPreTraining
< source >( config: ViTMAEConfig )
Параметры
- config (ViTMAEConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация с помощью файла конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Чтобы загрузить веса модели, используйте метод from_pretrained().
Модель ViTMAE — трансформер с декодером сверху для предобучения в режиме самообучения.
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonenoise: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool | None = Noneattention_mask: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → ViTMAEForPreTrainingOutput or tuple(torch.Tensor)
Параметры
- pixel_values (
torch.Tensorформы(batch_size, num_channels, image_size, image_size), необязательный) — Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью ViTImageProcessor. Подробности см. в ViTImageProcessor.call() (processor_classиспользует ViTImageProcessor для обработки изображений). - noise (
torch.Tensorформы(batch_size, sequence_length), необязательный) — Используется в основном для тестирования, чтобы контролировать случайность и обеспечивать воспроизводимость - interpolate_pos_encoding (
bool, необязательный, по умолчаниюFalse) — Указывает, следует ли интерполировать предобученные позиционные кодировки. Это в основном используется для применения модели к изображениям с более высоким разрешением. - attention_mask (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения токенов-заполнителей из внимания. Значения маски из диапазона[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
Возвращает
ViTMAEForPreTrainingOutput или tuple(torch.Tensor)
ViTMAEForPreTrainingOutput или кортеж из
torch.Tensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (ViTMAEConfig) и входных данных.
Метод forward класса ViTMAEForPreTraining переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
loss (
torch.Tensorформы(1,)) — Потеря пиксельной реконструкции.logits (
torch.Tensorформы(batch_size, sequence_length, patch_size ** 2 * num_channels)) — Логиты реконструкции пикселей.mask (
torch.Tensorформы(batch_size, sequence_length)) — тензор, указывающий, какие патчи замаскированы (1), а какие нет (0).ids_restore (
torch.LongTensorформы(batch_size, sequence_length)) — тензор, содержащий исходные индексы (перемешанных) замаскированных патчей.hidden_states (
tuple[torch.Tensor], необязательный, возвращается при передачеoutput_hidden_states=Trueили когдаconfig.output_hidden_states=True) — Кортеж изtorch.Tensor(один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
attentions (
tuple[torch.Tensor], необязательный, возвращается при передачеoutput_attentions=Trueили когдаconfig.output_attentions=True) — Кортежtorch.Tensor(по одному на каждый слой) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
>>> from transformers import AutoImageProcessor, ViTMAEForPreTraining
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read())).convert("RGB")

>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base")

>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> loss = outputs.loss
>>> mask = outputs.mask
>>> ids_restore = outputs.ids_restore