
Transformers documentation
ViTMAE
Este modelo se publicó en HF papers el 2021-11-11 y se contribuyó a Hugging Face Transformers el 2022-01-18.


ViTMAE
ViTMAE es un modelo de visión auto-supervisado que se preentrena enmascarando grandes porciones de una imagen (~75%). Un codificador procesa los parches de imagen visibles y un decodificador reconstruye los píxeles faltantes a partir de los parches codificados y los tokens de máscara. Después del preentrenamiento, el codificador puede reutilizarse para tareas posteriores como la clasificación de imágenes o la detección de objetos, superando con frecuencia a los modelos entrenados con aprendizaje supervisado.
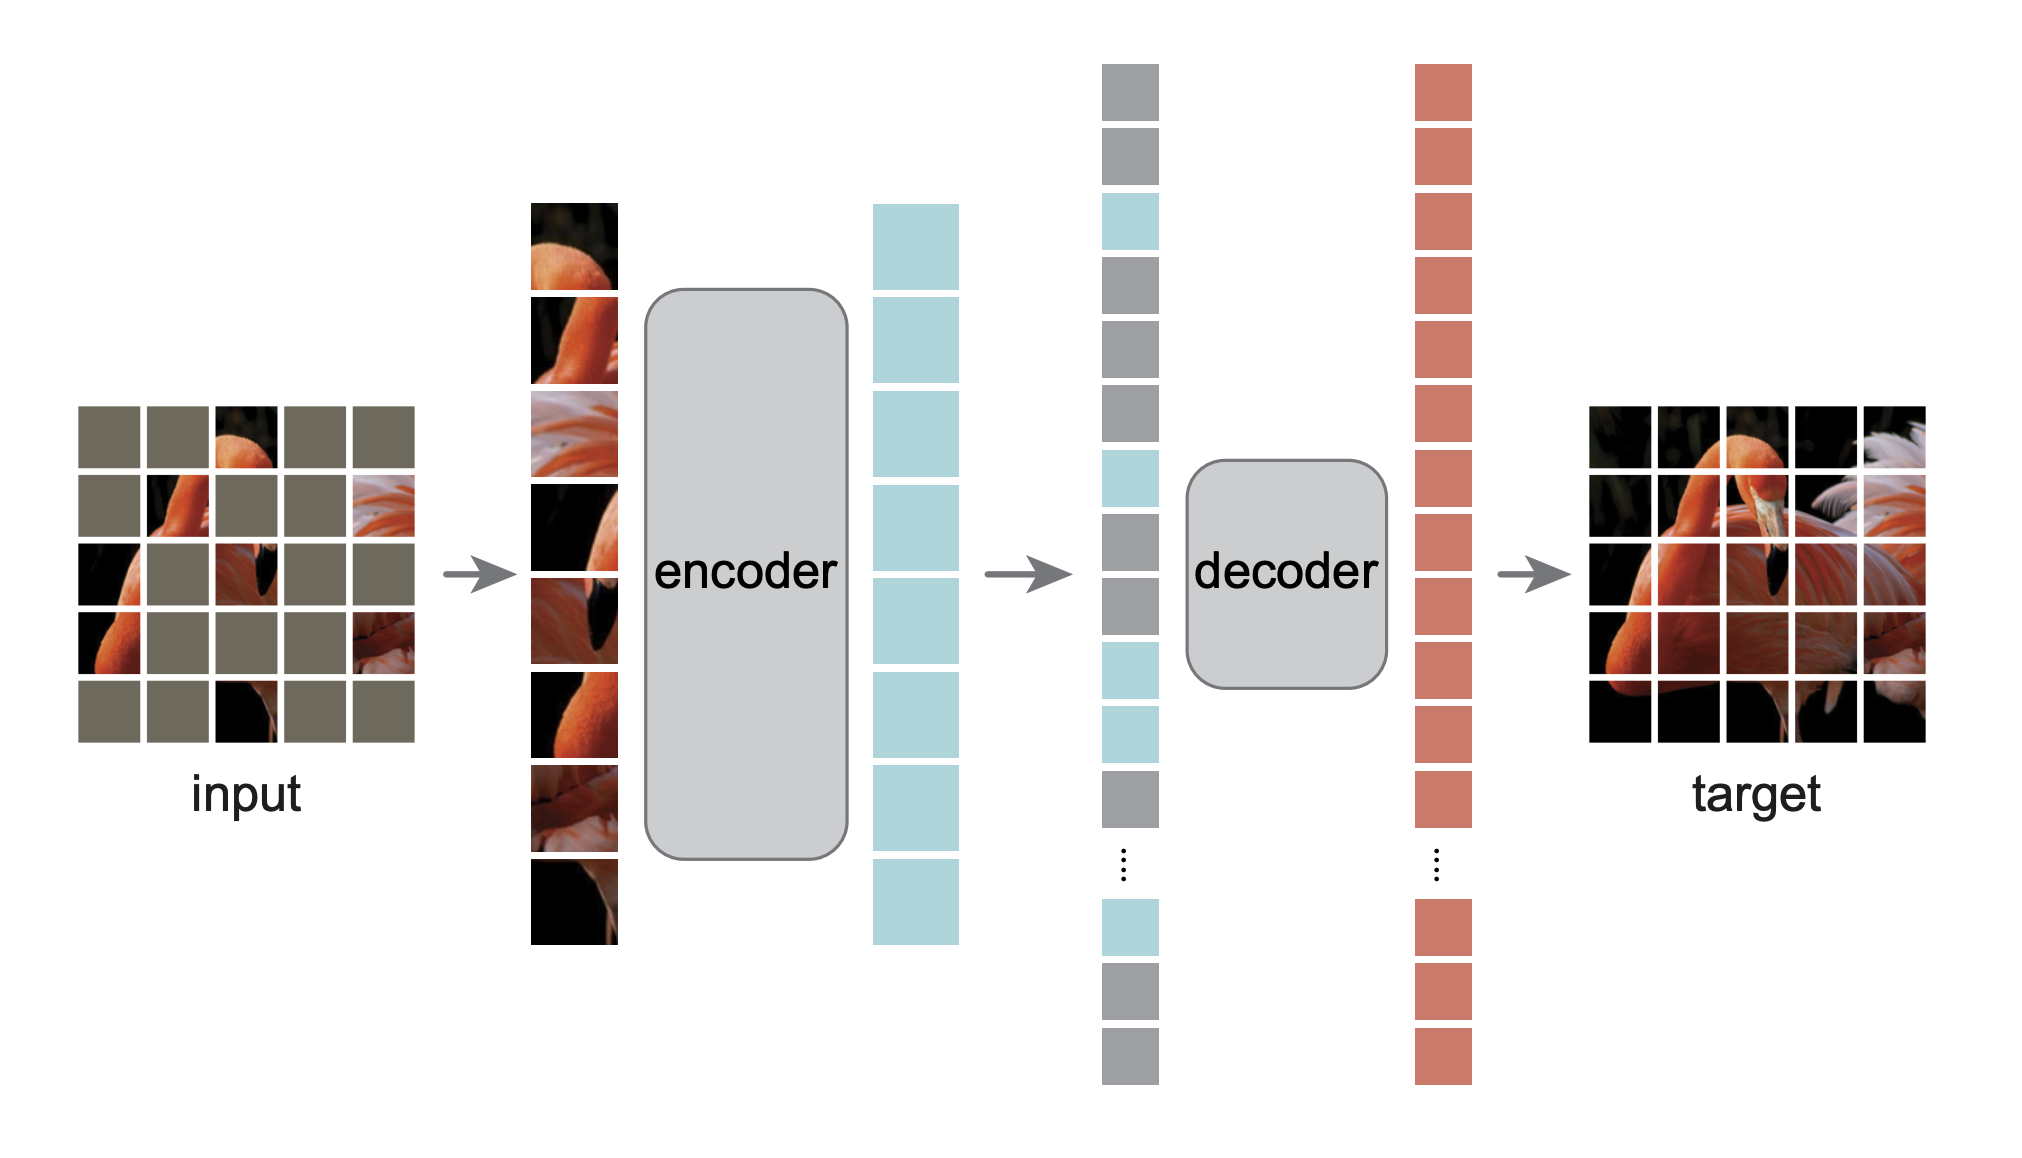
Puedes encontrar todos los puntos de control originales de ViTMAE en la organización AI at Meta.
Haz clic en los modelos ViTMAE en la barra lateral derecha para ver más ejemplos de cómo aplicar ViTMAE a tareas de visión.
El siguiente ejemplo demuestra cómo reconstruir los píxeles faltantes con la clase ViTMAEForPreTraining.
import requests
import torch
from PIL import Image

from transformers import ViTImageProcessor, ViTMAEForPreTraining


url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)

processor = ViTImageProcessor.from_pretrained("facebook/vit-mae-base")
inputs = processor(image, return_tensors="pt").to(model.device)
inputs = {k: v.to(model.device) for k, v in inputs.items()}

model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base", attn_implementation="sdpa", device_map="auto")
with torch.no_grad():
    outputs = model(**inputs)

reconstruction = outputs.logits
Notas
- ViTMAE se utiliza típicamente en dos etapas. Primero, un preentrenamiento auto-supervisado con ViTMAEForPreTraining y, a continuación, se descarta el decodificador y se ajusta el codificador. Después del ajuste fino, los pesos pueden integrarse en un modelo como ViTForImageClassification.
- Use ViTImageProcessor para la preparación de la entrada.
Recursos
- Consulte este cuaderno para aprender a visualizar los píxeles reconstruidos de ViTMAEForPreTraining.
ViTMAEConfig
clase transformers.ViTMAEConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.0attention_probs_dropout_prob: float | int = 0.0initializer_range: float = 0.02layer_norm_eps: float = 1e-12image_size: int | list[int] | tuple[int, int] = 224patch_size: int | list[int] | tuple[int, int] = 16num_channels: int = 3qkv_bias: bool = Truedecoder_num_attention_heads: int = 16decoder_hidden_size: int = 512decoder_num_hidden_layers: int = 8decoder_intermediate_size: int = 2048mask_ratio: float = 0.75norm_pix_loss: bool = False )
Parámetros
- hidden_size (
int, opcional, valor predeterminado768) — Dimensión de las representaciones ocultas. - num_hidden_layers (
int, opcional, valor predeterminado12) — Número de capas ocultas en el decodificador del Transformer. - num_attention_heads (
int, opcional, valor predeterminado12) — Número de cabezas de atención para cada capa de atención en el decodificador Transformer. - intermediate_size (
int, opcional, valor predeterminado3072) — Dimensión de las representaciones del MLP. - hidden_act (
str, opcional, valor predeterminadogelu) — La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo,"gelu","relu","silu", etc. - hidden_dropout_prob (
Union[float, int], opcional, valor predeterminado0.0) — La probabilidad de dropout para todas las capas totalmente conectadas en las incrustaciones, el codificador y el pooler. - attention_probs_dropout_prob (
Union[float, int], opcional, valor predeterminado0.0) — La proporción de dropout para las probabilidades de atención. - initializer_range (
float, opcional, valor predeterminado0.02) — La desviación estándar del truncated_normal_initializer para inicializar todas las matrices de pesos. - layer_norm_eps (
float, opcional, valor predeterminado1e-12) — El epsilon utilizado por las capas de normalización de capa. - image_size (
Union[int, list[int], tuple[int, int]], opcional, valor predeterminado224) — El tamaño (resolución) de cada imagen. - patch_size (
Union[int, list[int], tuple[int, int]], opcional, valor predeterminado16) — El tamaño (resolución) de cada parche. - num_channels (
int, opcional, valor predeterminado3) — El número de canales de entrada. - qkv_bias (
bool, opcional, valor predeterminadoTrue) — Si se debe añadir un sesgo a las consultas, claves y valores. - decoder_num_attention_heads (
int, opcional, valor predeterminado16) — Número de cabezas de atención para cada capa de atención en el decodificador del Transformer. - decoder_hidden_size (
int, opcional, valor predeterminado512) — Dimensión de las representaciones ocultas. - decoder_num_hidden_layers (
int, opcional, valor predeterminado: 8) — Número de capas ocultas en el decodificador. - decoder_intermediate_size (
int, opcional, valor predeterminado2048) — Dimensión de las representaciones MLP. - mask_ratio (
float, opcional, valor predeterminado 0.75) — La proporción de tokens enmascarados en la secuencia de entrada. - norm_pix_loss (
bool, opcional, valor predeterminadoFalse) — Indica si se debe entrenar con píxeles normalizados (véase la Tabla 3 del artículo). El uso de píxeles normalizados mejoró la calidad de la representación en los experimentos de los autores.
Esta es la clase de configuración para almacenar la configuración de un ViTMAEModel. Se utiliza para instanciar un modelo Vit Mae según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de facebook/vit-mae-base
Los objetos de configuración heredan de PreTrainedConfig y se pueden usar para controlar las salidas del modelo. Lea la documentación de PreTrainedConfig para obtener más información.
Ejemplo:
>>> from transformers import ViTMAEConfig, ViTMAEModel

>>> # Initializing a ViT MAE vit-mae-base style configuration
>>> configuration = ViTMAEConfig()

>>> # Initializing a model (with random weights) from the vit-mae-base style configuration
>>> model = ViTMAEModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
ViTMAEModel
clase transformers.ViTMAEModel
< source >( config: ViTMAEConfig )
Parámetros
- config (ViTMAEConfig) — Configuración del modelo.
El modelo Vit Mae básico que emite estados ocultos sin ningún cabezal específico en la parte superior.
Este modelo hereda de PreTrainedModel. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de torch.nn.Module de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonenoise: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool | None = Noneattention_mask: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → ViTMAEModelOutput or tuple(torch.Tensor)
Parámetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener utilizando ViTImageProcessor. Consulte ViTImageProcessor.call() para más detalles (processor_classutiliza ViTImageProcessor para procesar las imágenes). - noise (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Se utiliza principalmente con fines de prueba para controlar la aleatoriedad y mantener la reproducibilidad - interpolate_pos_encoding (
bool, opcional, valor predeterminadoFalse) — Indica si se deben interpolar las codificaciones de posición preentrenadas. Esto se utiliza principalmente para emplear el modelo con imágenes de mayor resolución. - attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de máscara seleccionados en[0, 1]:- 1 para los tokens que no están enmascarados,
- 0 para los tokens que están enmascarados.
Devuelve
ViTMAEModelOutput o tuple(torch.Tensor)
Un ViTMAEModelOutput o una tupla de
torch.Tensor (si se pasa return_dict=False o cuando config.return_dict=False) que comprende varios
elementos según la configuración (ViTMAEConfig) y las entradas.
El método forward de ViTMAEModel reemplaza el método especial __call__.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de
Moduledespués en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de pre y postprocesamiento, mientras que la segunda los ignora silenciosamente.
last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Secuencia de estados ocultos en la salida de la última capa del modelo.mask (
torch.Tensorde forma(batch_size, sequence_length)) — Tensor que indica qué parches están enmascarados (1) y cuáles no (0).ids_restore (
torch.LongTensorde forma(batch_size, sequence_length)) — Tensor que contiene el índice original de los parches enmascarados (barajados).hidden_states (
tuple[torch.Tensor], opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma(batch_size, sequence_length, hidden_size).Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
attentions (
tuple[torch.Tensor], opcional, se devuelve cuando se pasaoutput_attentions=Trueo cuandoconfig.output_attentions=True) — Tupla detorch.Tensor(una por cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
>>> from transformers import AutoImageProcessor, ViTMAEModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEModel.from_pretrained("facebook/vit-mae-base")

>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
ViTMAEForPreTraining
clase transformers.ViTMAEForPreTraining
< source >( config: ViTMAEConfig )
Parámetros
- config (ViTMAEConfig) — Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método from_pretrained() para cargar los pesos del modelo.
El transformer del modelo ViTMAE con el decodificador en la parte superior para el preentrenamiento auto-supervisado.
Este modelo hereda de PreTrainedModel. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de torch.nn.Module de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonenoise: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool | None = Noneattention_mask: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → ViTMAEForPreTrainingOutput or tuple(torch.Tensor)
Parámetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener utilizando ViTImageProcessor. Consulte ViTImageProcessor.call() para más detalles (processor_classutiliza ViTImageProcessor para procesar las imágenes). - noise (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Se utiliza principalmente con fines de prueba para controlar la aleatoriedad y mantener la reproducibilidad - interpolate_pos_encoding (
bool, opcional, valor predeterminadoFalse) — Indica si se deben interpolar las codificaciones de posición preentrenadas. Esto se utiliza principalmente para emplear el modelo con imágenes de mayor resolución. - attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de máscara seleccionados en[0, 1]:- 1 para los tokens que no están enmascarados,
- 0 para los tokens que están enmascarados.
Devuelve
ViTMAEForPreTrainingOutput o tuple(torch.Tensor)
Un ViTMAEForPreTrainingOutput o una tupla de
torch.Tensor (si se pasa return_dict=False o cuando config.return_dict=False) que comprende varios
elementos según la configuración (ViTMAEConfig) y las entradas.
El método forward de ViTMAEForPreTraining reemplaza el método especial __call__.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de
Moduledespués en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de pre y postprocesamiento, mientras que la segunda los ignora silenciosamente.
loss (
torch.Tensorde forma(1,)) — Pérdida de reconstrucción de píxeles.logits (
torch.Tensorde forma(batch_size, sequence_length, patch_size ** 2 * num_channels)) — Logits de reconstrucción de píxeles.mask (
torch.Tensorde forma(batch_size, sequence_length)) — Tensor que indica qué parches están enmascarados (1) y cuáles no (0).ids_restore (
torch.LongTensorde forma(batch_size, sequence_length)) — Tensor que contiene el índice original de los parches enmascarados (barajados).hidden_states (
tuple[torch.Tensor], opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma(batch_size, sequence_length, hidden_size).Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
attentions (
tuple[torch.Tensor], opcional, se devuelve cuando se pasaoutput_attentions=Trueo cuandoconfig.output_attentions=True) — Tupla detorch.Tensor(una por cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
>>> from transformers import AutoImageProcessor, ViTMAEForPreTraining
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read())).convert("RGB")

>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base")

>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> loss = outputs.loss
>>> mask = outputs.mask
>>> ids_restore = outputs.ids_restore