
LeRobot documentation
Meta-World
Meta-World
Meta-World là một benchmark mô phỏng mã nguồn mở cho học tăng cường đa nhiệm và siêu học trong điều khiển liên tục của thao tác robot. Nó bao gồm 50 nhiệm vụ thao tác đa dạng sử dụng các vật dụng hàng ngày và cánh tay Sawyer chung trên bàn, cung cấp một môi trường chuẩn hóa để kiểm tra xem các thuật toán có thể học nhiều nhiệm vụ khác nhau và khái quát hóa nhanh chóng sang các nhiệm vụ mới hay không.
- Bài báo: Bài báo Meta-World: Một bộ chuẩn và đánh giá cho học tăng cường đa nhiệm và siêu
- GitHub: Farama-Foundation/Metaworld
- Trang web dự án: metaworld.farama.org
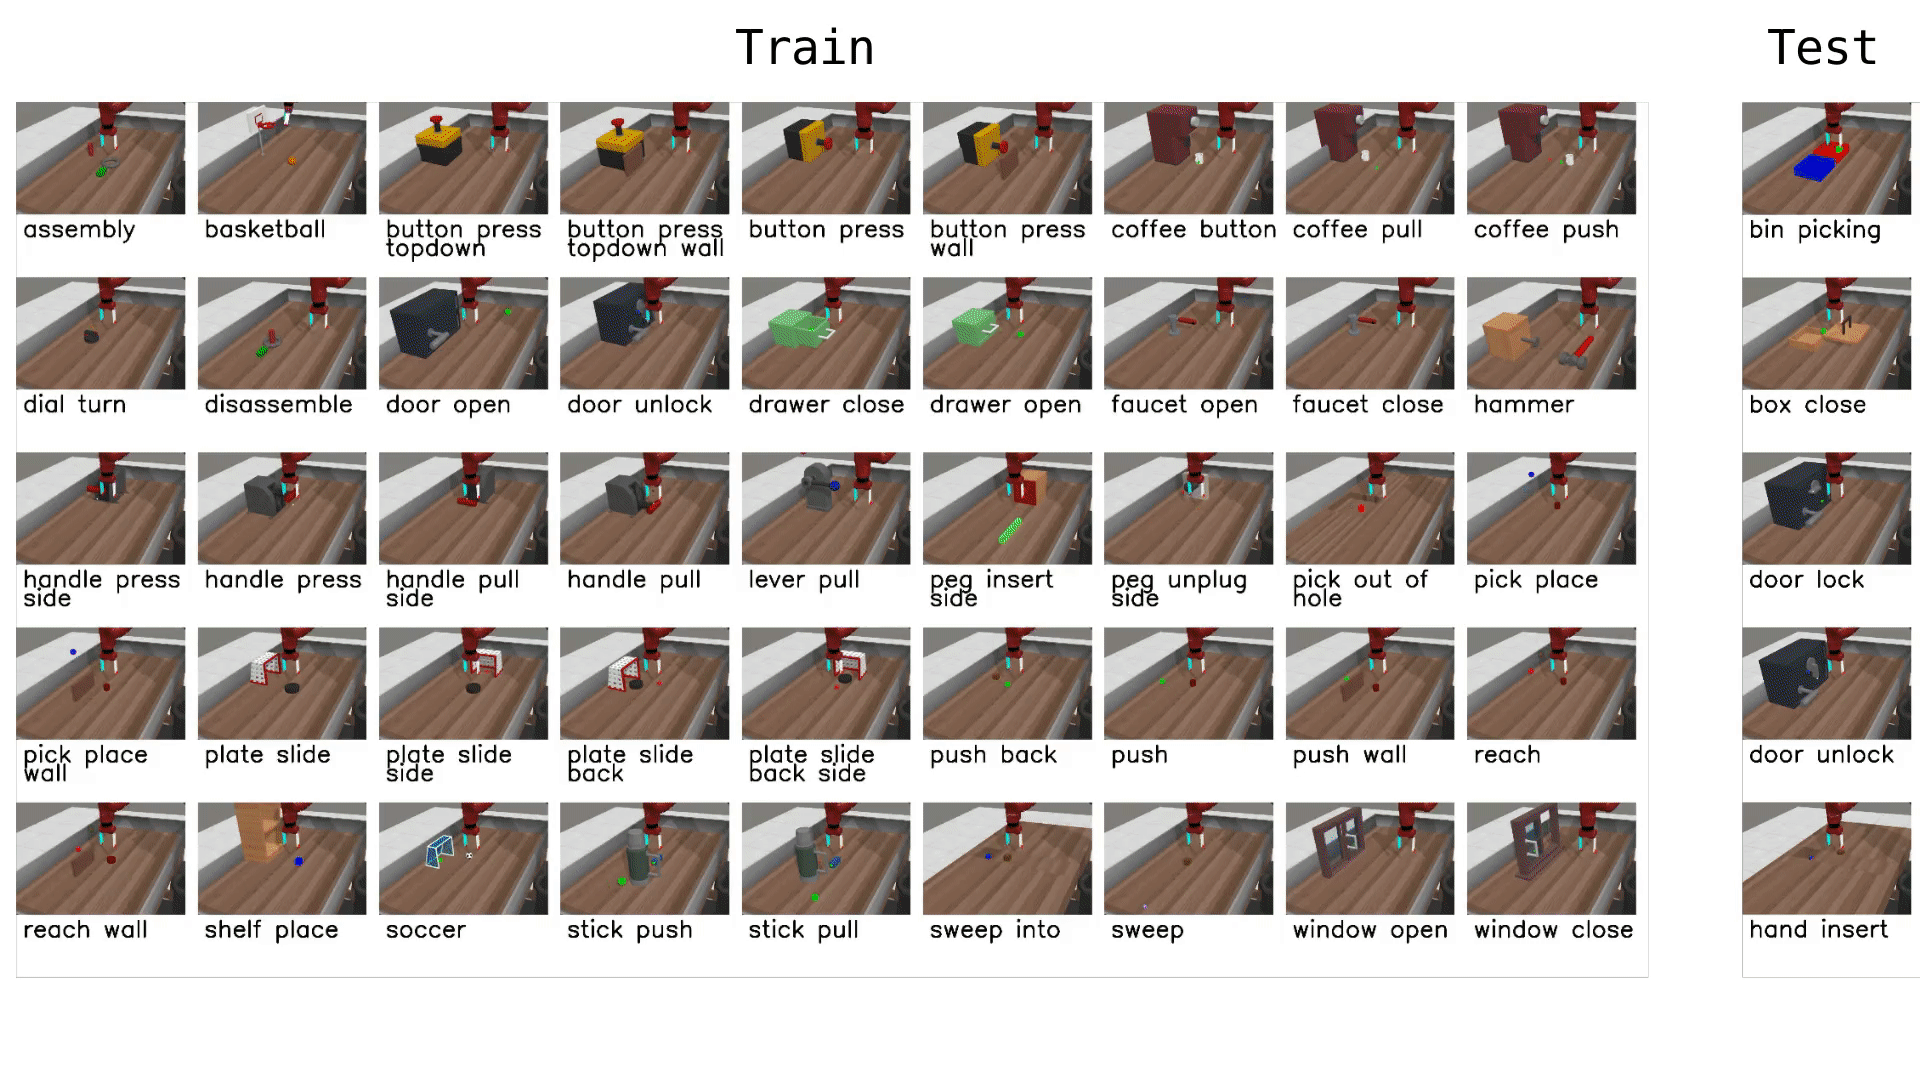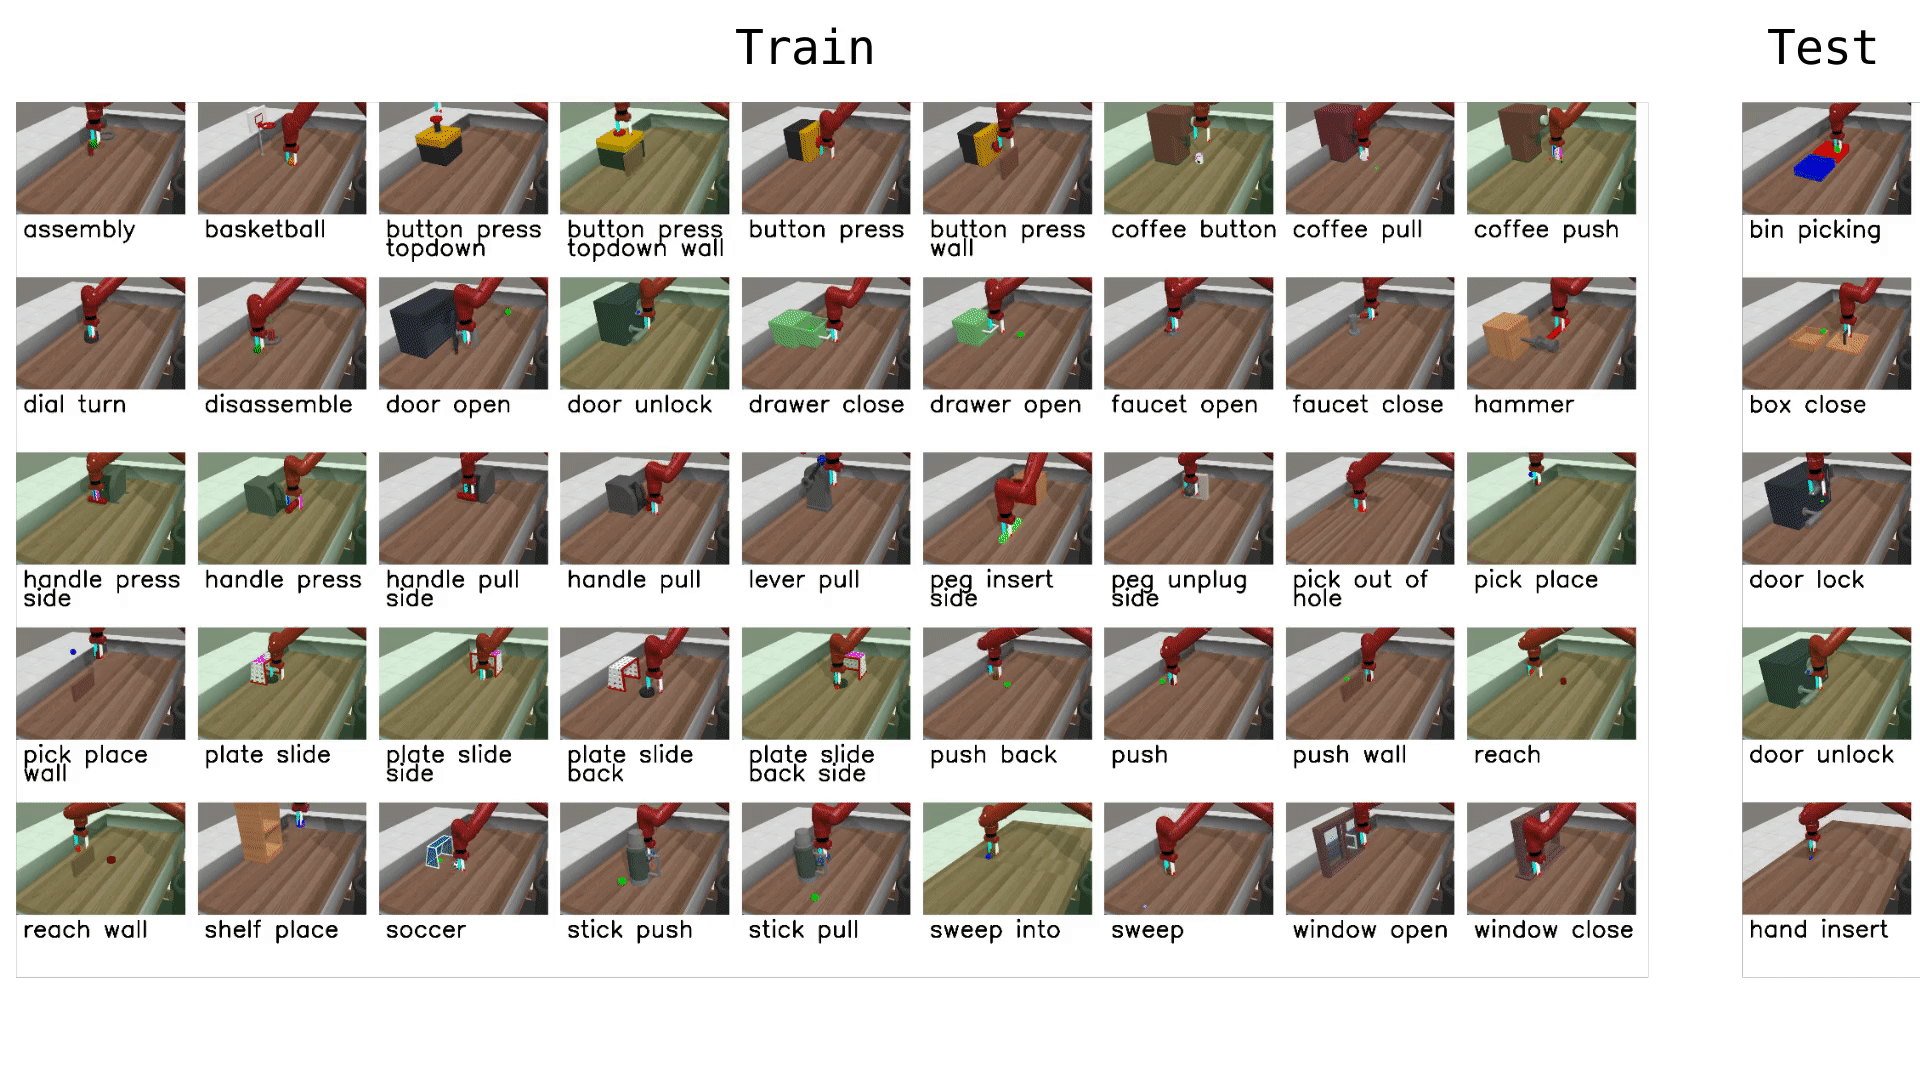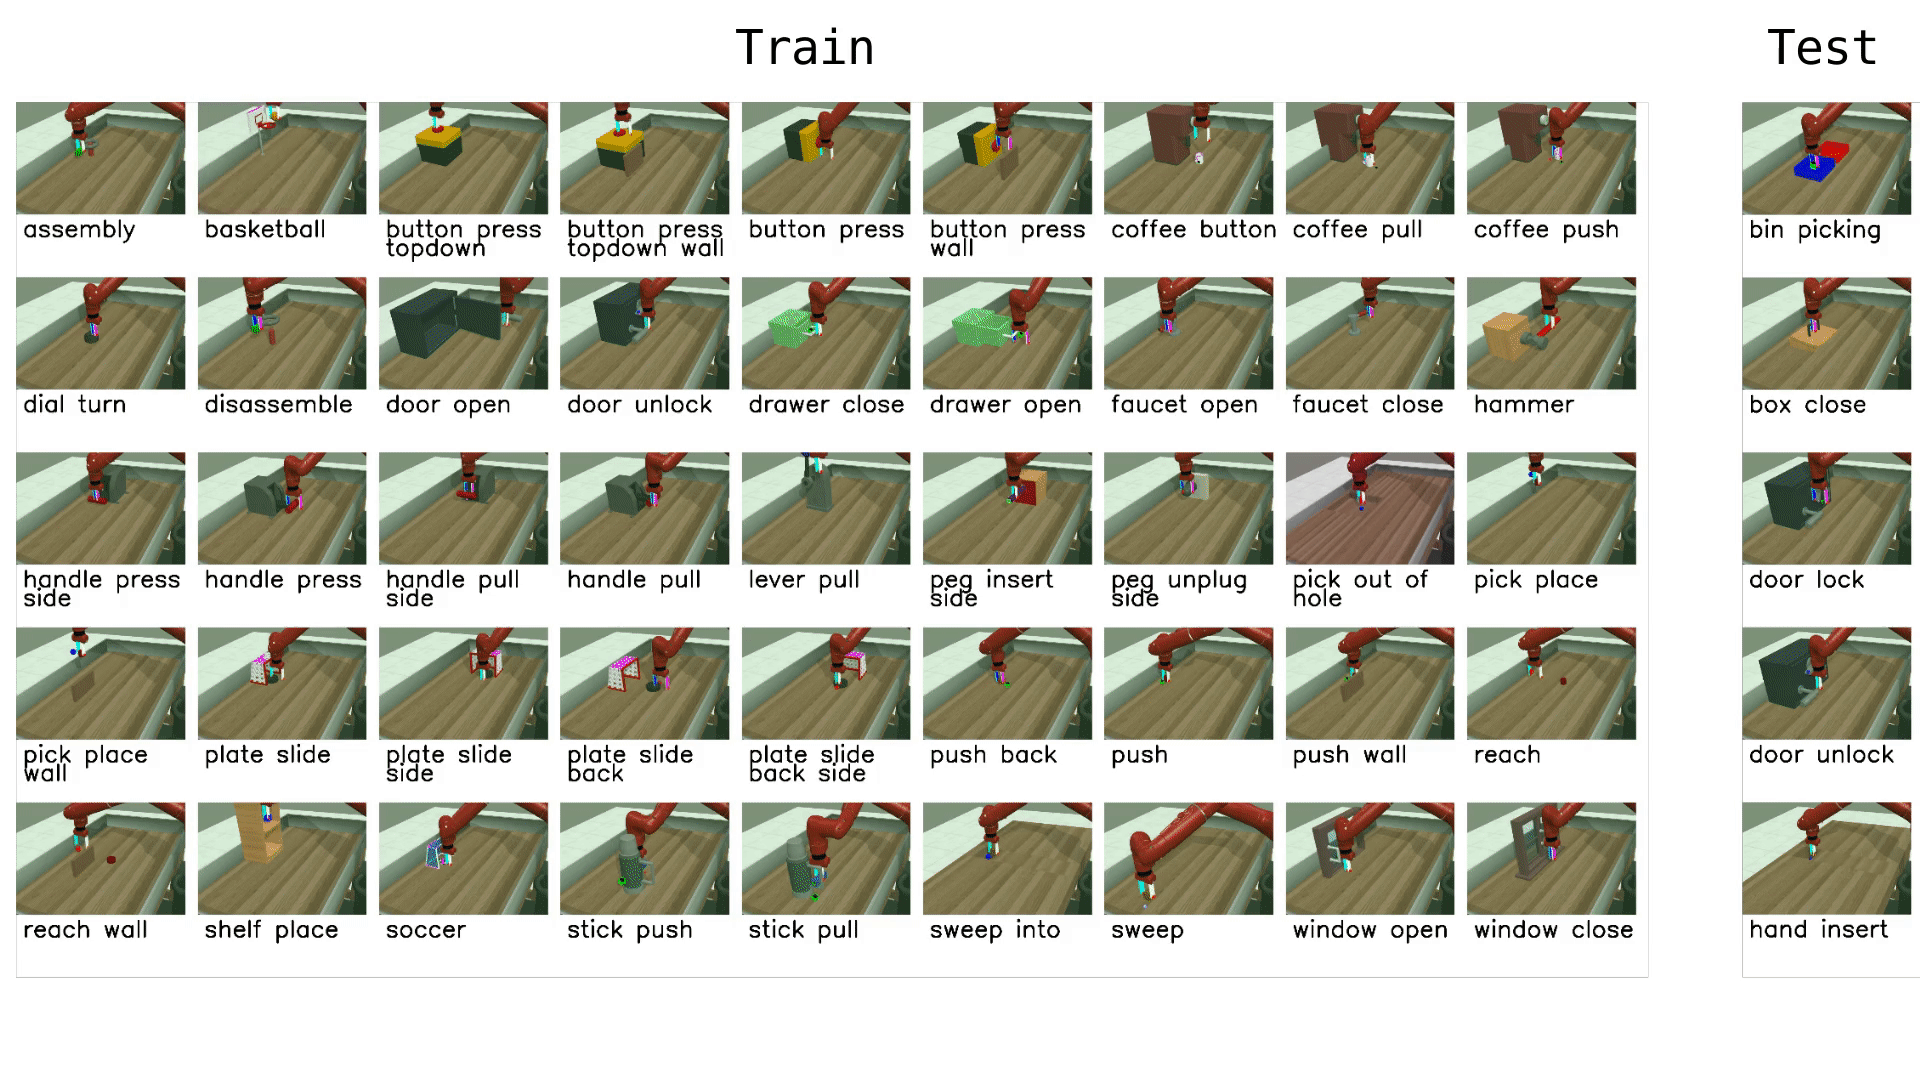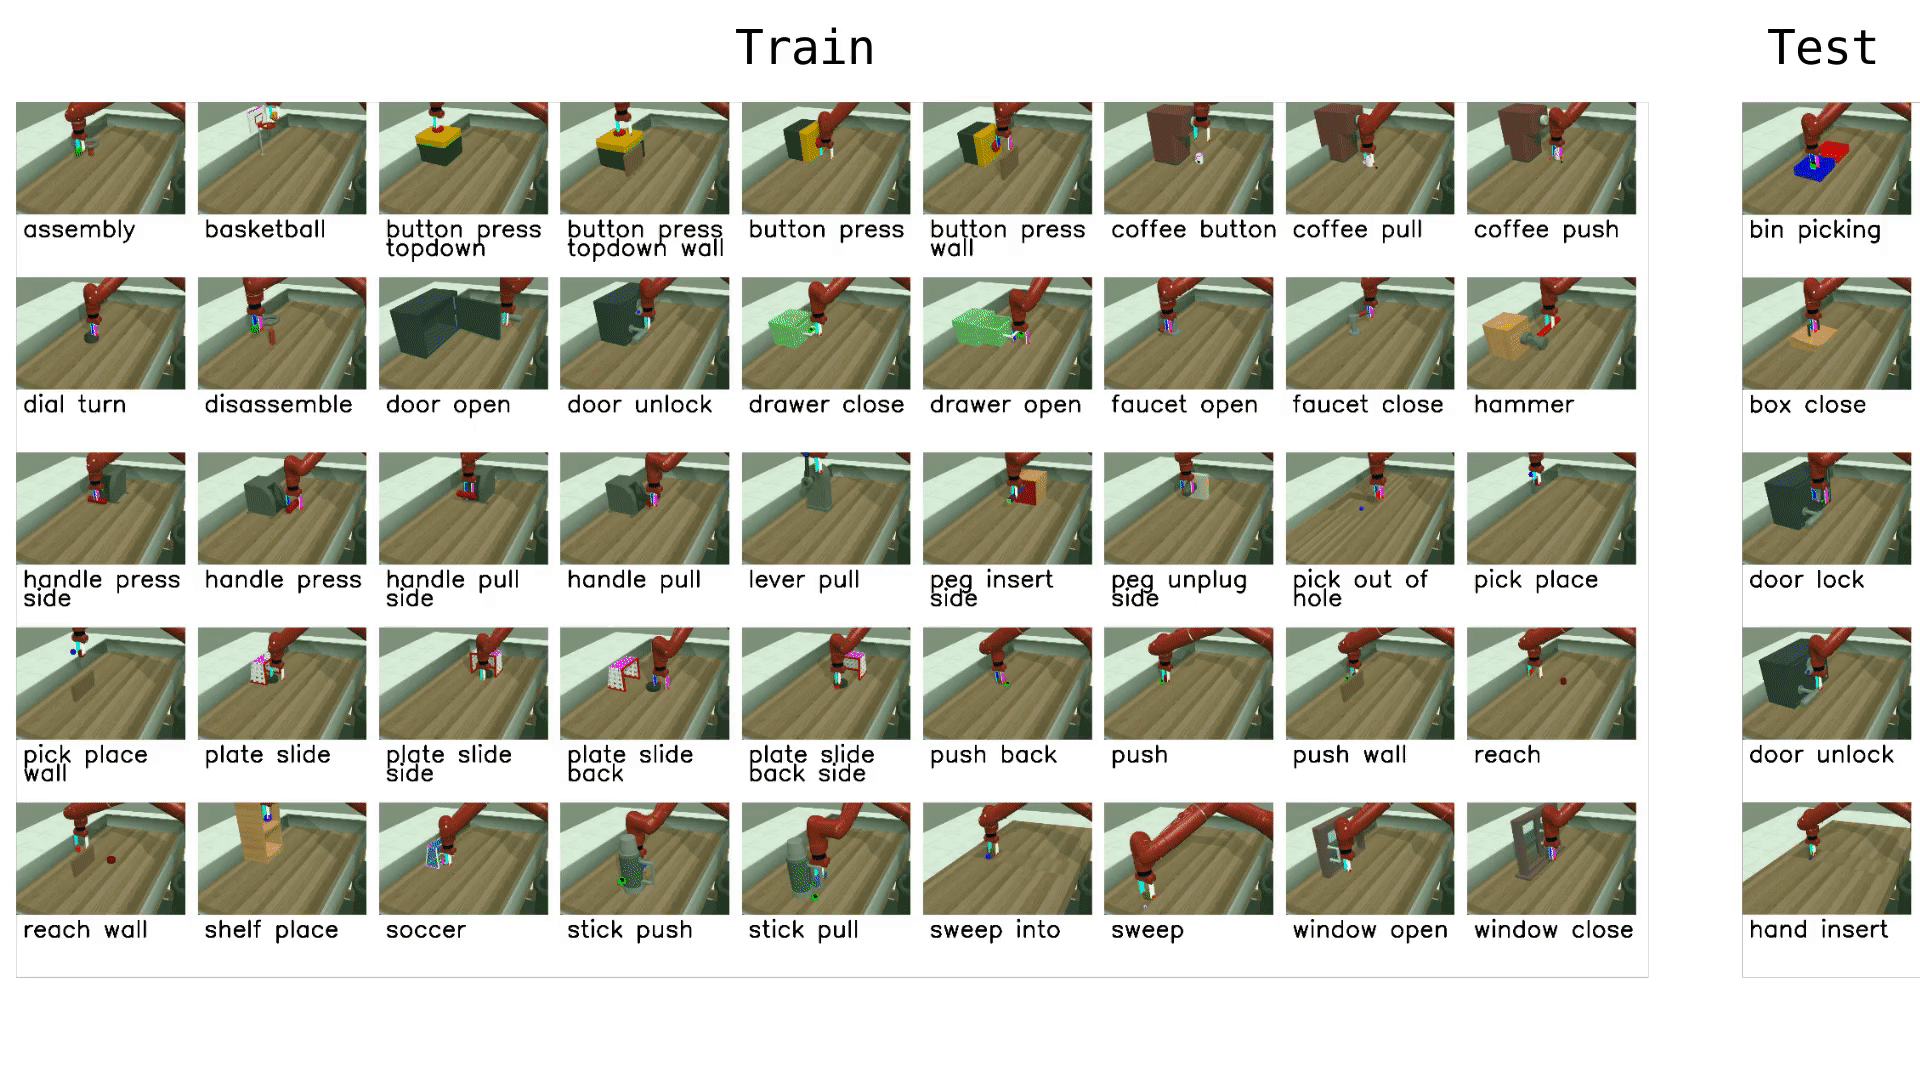
Các tác vụ khả dụng
Meta-World cung cấp 50 tác vụ được tổ chức thành các nhóm độ khó. Trong LeRobot, bạn có thể đánh giá trên từng tác vụ riêng lẻ, các nhóm độ khó, hoặc toàn bộ bộ MT50:
| Nhóm | Tên CLI | Nhiệm vụ | Mô tả |
|---|---|---|---|
| Dễ | easy | 28 | Các tác vụ có động lực đơn giản và mục tiêu một bước |
| Trung bình | medium | 11 | Các tác vụ đòi hỏi suy luận nhiều bước |
| Khó | hard | 6 | Các tác vụ với tiếp xúc phức tạp và thao tác chính xác |
| Rất Khó | very_hard | 5 | Các tác vụ khó khăn nhất trong bộ bài tập |
| MT50 (tất cả) | Danh sách phân tách bằng dấu phẩy | 50 | Cả 50 tác vụ — cấu hình đa tác vụ đầy thách thức nhất |
Bạn cũng có thể truyền trực tiếp tên từng tác vụ (ví dụ: assembly-v3, dial-turn-v3).
Chúng tôi cung cấp một bộ dữ liệu sẵn sàng cho LeRobot dành cho Meta-World MT50 trên HF Hub: lerobot/metaworld_mt50. Bộ dữ liệu này được định dạng cho việc đánh giá MT50, sử dụng tất cả 50 tác vụ với vị trí đối tượng/mục tiêu cố định và các vector tác vụ one-hot để đảm bảo tính nhất quán.
Cài đặt
Sau khi làm theo các hướng dẫn cài đặt LeRobot:
pip install -e ".[metaworld]"If you encounter an `AssertionError: ['human', 'rgb_array', 'depth_array']` when running Meta-World environments, this is a mismatch between Meta-World and your Gymnasium version. Reinstall the Gymnasium version LeRobot supports (Meta-World `3.0.0` works with it):pip install "gymnasium>=1.1.1,<2.0.0"
Đánh giá
Đánh giá mặc định (khuyến nghị)
Đánh giá trên tập dữ liệu có độ khó trung bình (cân bằng tốt giữa độ bao phủ và chi phí tính toán):
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=metaworld \
  --env.task=medium \
  --eval.batch_size=1 \
  --eval.n_episodes=10
Đánh giá tác vụ đơn
Đánh giá trên một tác vụ cụ thể:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=metaworld \
  --env.task=assembly-v3 \
  --eval.batch_size=1 \
  --eval.n_episodes=10
Đánh giá đa nhiệm
Đánh giá trên nhiều tác vụ hoặc nhóm độ khó:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=metaworld \
  --env.task=assembly-v3,dial-turn-v3,handle-press-side-v3 \
  --eval.batch_size=1 \
--eval.n_episodes=10--env.taskchấp nhận danh sách tác vụ rõ ràng (phân tách bằng dấu phẩy) hoặc các nhóm độ khó (ví dụ:easy,medium,hard,very_hard).--eval.batch_sizekiểm soát số lượng môi trường chạy song song.--eval.n_episodesthiết lập số lượng episode cần chạy cho mỗi task.
Đầu vào và đầu ra của Policy
Quan sát:
observation.image— góc nhìn từ một camera (corner2), 480x480 HWC uint8observation.state— trạng thái cảm nhận bản thân 4 chiều (vị trí đầu hiệu ứng + kẹp)
Thao tác:
- Điều khiển liên tục trong
Box(-1, 1, shape=(4,))— delta đầu cuối 3D + kẹp 1D
Các tập đánh giá được khuyến nghị
Để benchmark có thể tái lập, hãy sử dụng 10 episode cho mỗi task. Với bộ MT50 đầy đủ, điều này cho ra tổng cộng 500 episode. Nếu bạn quan tâm đến khả năng tổng quát hóa, hãy chạy trên toàn bộ MT50 — nó được thiết kế để gây thách thức và bộc lộ điểm mạnh/điểm yếu tốt hơn so với một vài task hẹp.
Huấn luyện
Lệnh huấn luyện mẫu
Huấn luyện một chính sách SmolVLA trên một tập con các tác vụ Meta-World:
lerobot-train \
  --policy.type=smolvla \
  --policy.repo_id=${HF_USER}/metaworld-test \
  --policy.load_vlm_weights=true \
  --dataset.repo_id=lerobot/metaworld_mt50 \
  --env.type=metaworld \
  --env.task=assembly-v3,dial-turn-v3,handle-press-side-v3 \
  --output_dir=./outputs/ \
  --steps=100000 \
  --batch_size=4 \
  --eval.batch_size=1 \
  --eval.n_episodes=1 \
  --env_eval_freq=1000
Mẹo thực hành
- Sử dụng điều kiện tác vụ one-hot cho huấn luyện đa tác vụ (quy ước MT10/MT50) để các chính sách có ngữ cảnh tác vụ rõ ràng.
- Kiểm tra mô tả tác vụ của bộ dữ liệu và các khóa
info["is_success"]khi viết hậu xử lý hoặc ghi log để các chỉ số thành công của bạn khớp với benchmark. - Điều chỉnh
batch_size,stepsvàenv_eval_freqcho phù hợp với ngân sách tính toán của bạn.