
LeRobot documentation
LIBERO
LIBERO
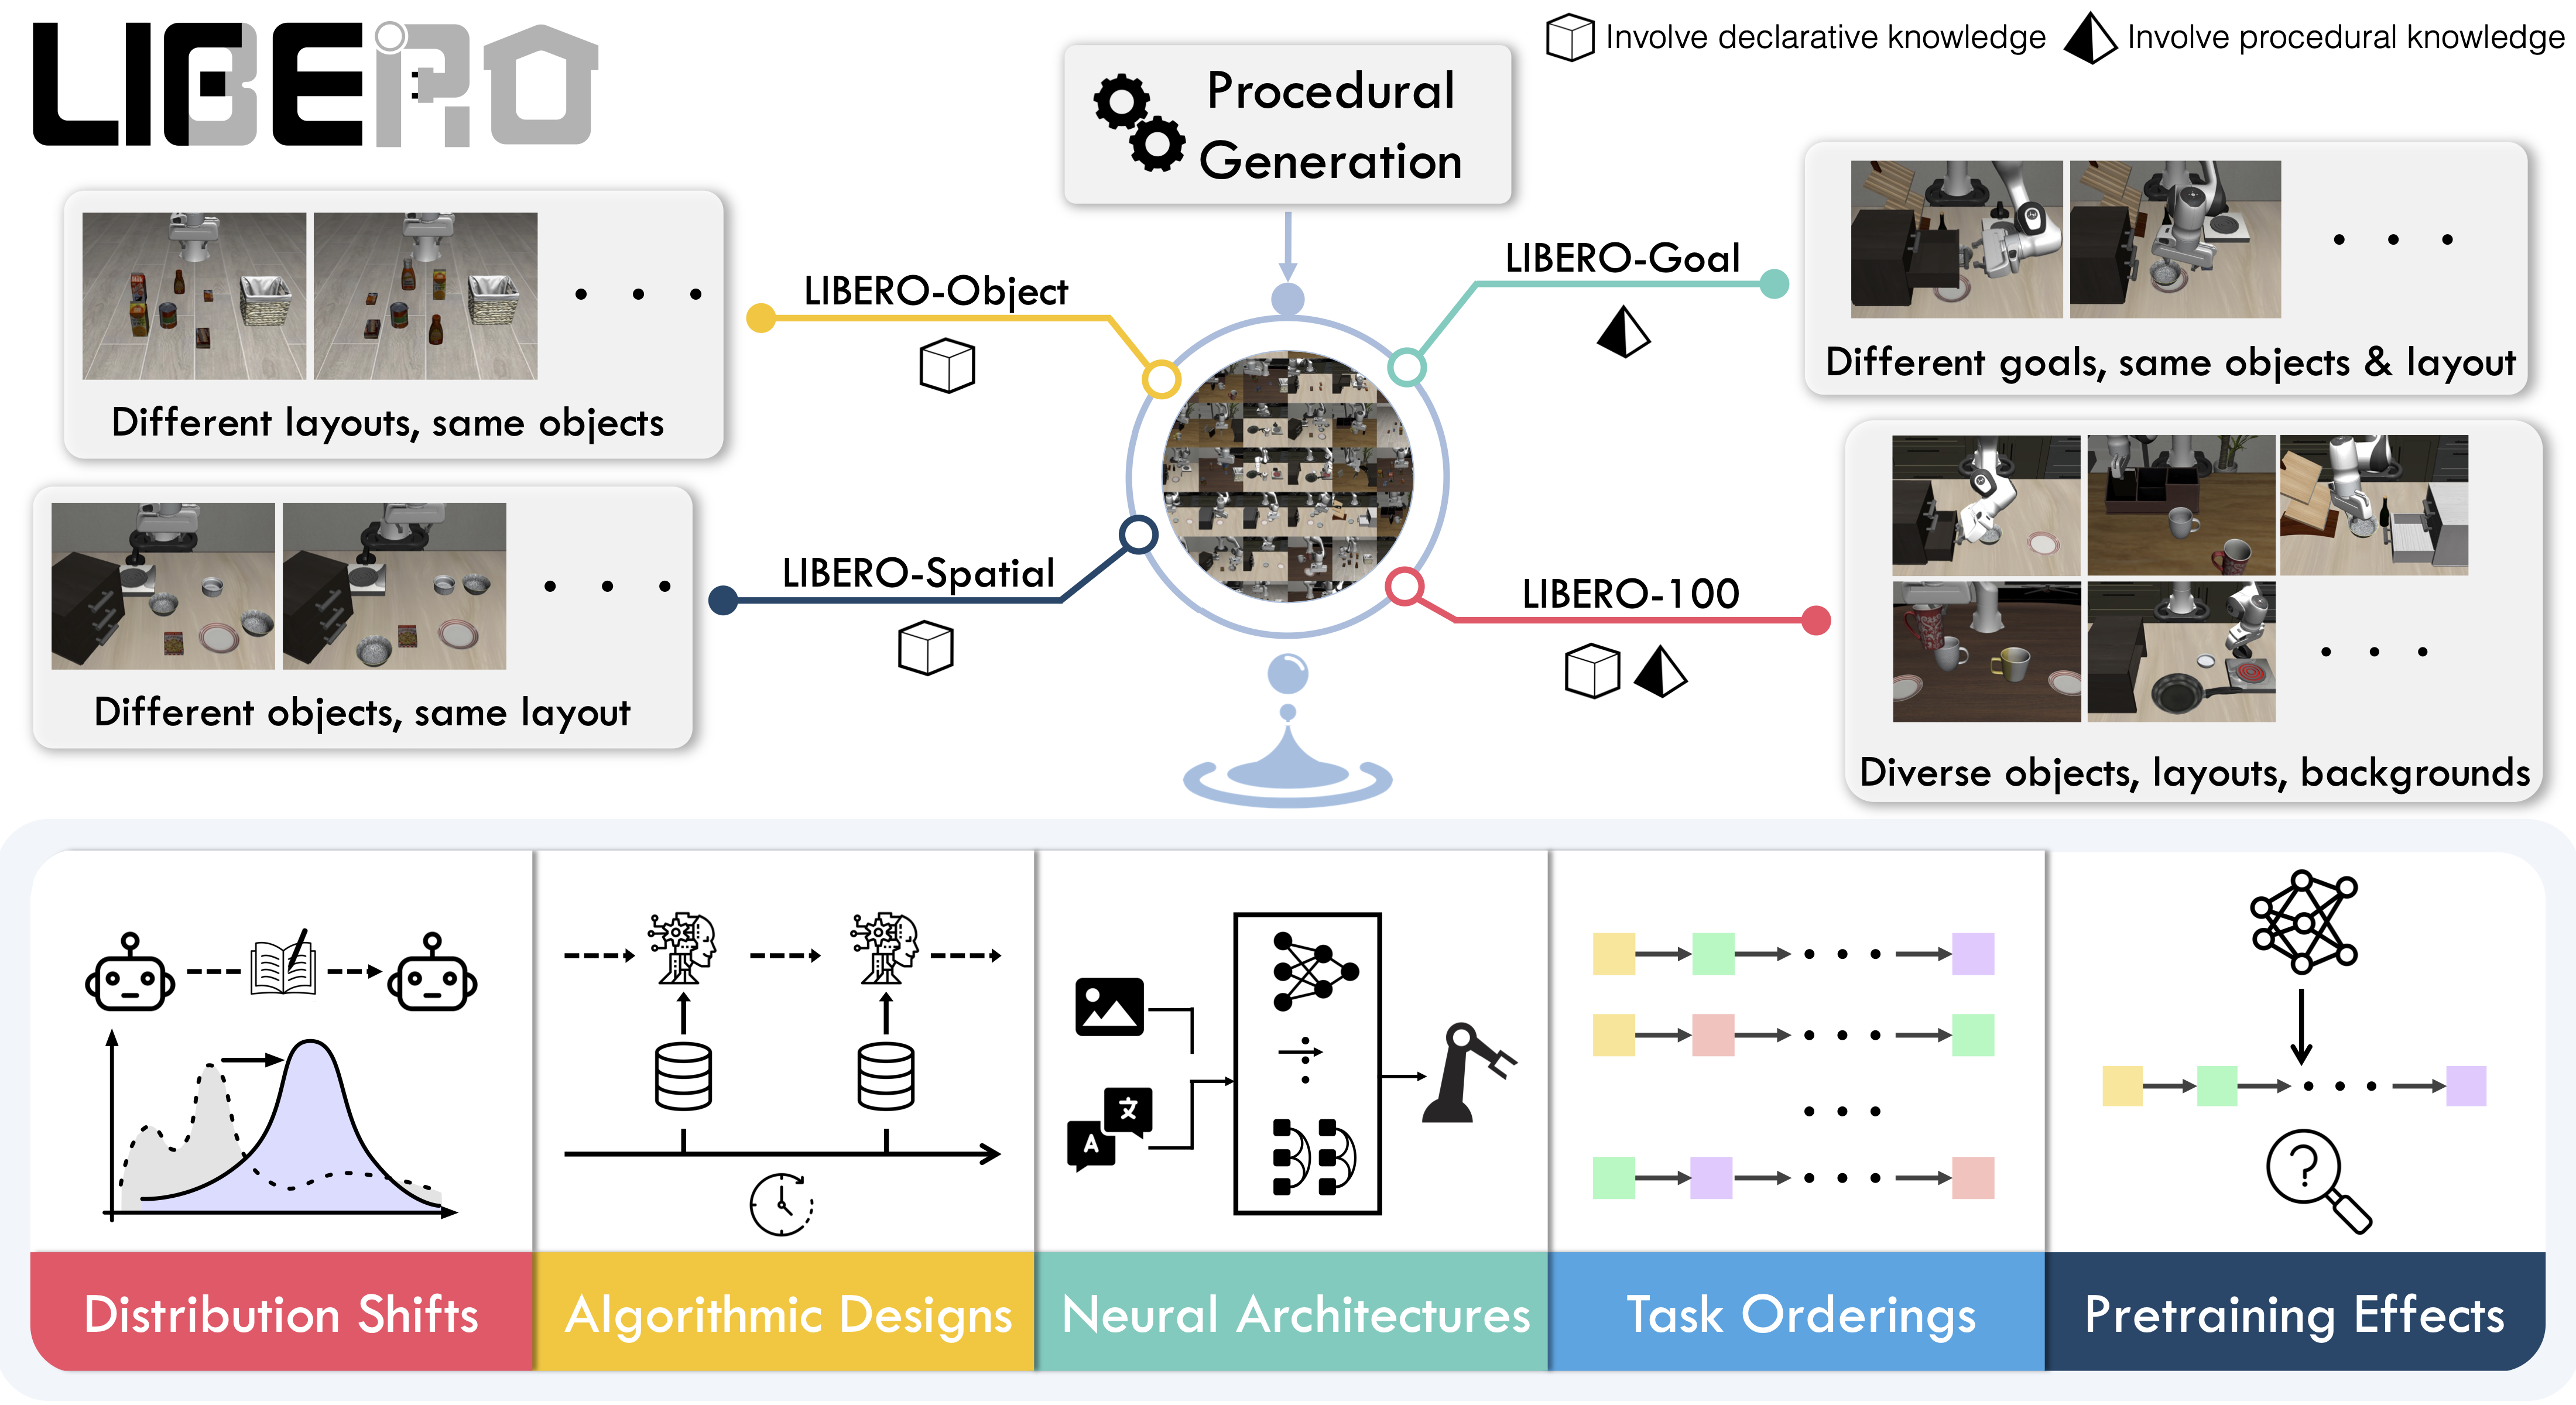
LIBEROは、ロボットの生涯学習を研究するために設計されたベンチマークです。これは、ロボットが一度だけ事前学習を受けるだけでなく、ユーザーとともに時間とともに学習し適応し続ける必要があるという考えに基づいています。LIBEROは、知識転移に焦点を当てた標準化された操作タスクのセットを提供します。つまり、ロボットがすでに学んだことを新しい状況にどの程度適用できるかという点です。LIBEROでの評価により、異なるアルゴリズムを公平に比較でき、研究者は互いの研究を基盤として発展させることができます。
- 論文: Benchmarking Knowledge Transfer for Lifelong Robot Learning
- GitHub: Lifelong-Robot-Learning/LIBERO
- プロジェクトウェブサイト: libero-project.github.io
利用可能なタスク
LIBEROには、単純なオブジェクト操作から複雑なマルチステップシナリオまで、130のタスクをカバーする5つのタスクスイートが含まれています:
| スイート | CLI名 | タスク | 説明 |
|---|---|---|---|
| LIBERO-Spatial | libero_spatial | 10 | 空間的な関係について推論を必要とするタスク |
| LIBERO-Object | libero_object | 10 | 異なるオブジェクトを操作するタスク |
| LIBERO-Goal | libero_goal | 10 | ターゲットが変化するゴール条件付きタスク |
| LIBERO-90 | libero_90 | 90 | LIBERO-100コレクションからの短期間タスク |
| LIBERO-Long | libero_10 | 10 | LIBERO-100コレクションからの長期ホライズンタスク |
インストール
LeRobotのインストール手順に従った後:
pip install -e ".[libero]"LIBERO requires Linux (`sys_platform == 'linux'`). LeRobot uses MuJoCo for simulation — set the rendering backend before training or evaluation:export MUJOCO_GL=egl # for headless servers (HPC, cloud)
評価
デフォルトの評価(推奨)
4つの標準スイート全体で評価します(タスクごとに10エピソード):
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --env.max_parallel_tasks=1
単一スイートの評価
1つのLIBEROスイートで評価する:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object \
  --eval.batch_size=2 \
--eval.n_episodes=3--env.taskはスイート(libero_object、libero_spatialなど)を選択します。--env.task_idsを使用すると、特定のタスクのインデックス([0]、[1,2,3]など)に限定できます。省略すると、スイート内のすべてのタスクが実行されます。--eval.batch_sizeは、並列で実行される環境の数を制御します。--eval.n_episodesは、タスクごとに実行するエピソード数を設定します。
マルチスイート評価
カンマ区切りのリストを渡すことで、複数のスイートにまたがってポリシーをベンチマークできます:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object,libero_spatial \
  --eval.batch_size=1 \
  --eval.n_episodes=2
制御モード
LIBEROは2つの制御モードをサポートしています。relative(デフォルト)とabsoluteです。異なるVLAチェックポイントは異なるアクションのパラメータ化で学習されているため、ポリシーにモードが一致していることを確認してください。
--env.control_mode=relative # or "absolute"パフォーマンスのリセット
デフォルトでは、LeRobotはLIBEROのハードリセット動作を維持します。固定初期状態を有効にすると、エピソードごとにシミュレータモデルとレンダラーを再構築することをスキップするために、ソフトリセットを選択できます。
--env.init_states=true --env.hard_reset=falseソフトリセットは高速ですが、環境の安定化ステップ以降はハードリセットとビット単位で同一にはなりません。そのため、カメラの観測値やポリシーの結果がわずかに異なる場合があります。ベンチマークの結果を再現する場合は、ハードリセットを使用してください。
ポリシーの入力と出力
観察結果:
observation.state— 8次元のプロプライオセプティブ特徴量(eef位置、軸角方向、グリップa qpos)observation.images.image— メインカメラの映像(agentview_image)、HWC uint8observation.images.image2— 手首カメラの映像(robot0_eye_in_hand_image)、HWC uint8
LeRobot enforces the `.images.*` prefix for visual features. Ensure your policy config `input_features` use the same naming keys, and that your dataset metadata keys follow this convention. If your data contains different keys, you must rename the observations to match what the policy expects, since naming keys are encoded inside the normalization statistics layer.
アクション:
Box(-1, 1, shape=(7,))における連続制御 — 6次元のエンドエフェクターのデルタ + 1次元のグリップ
推奨される評価エピソード
再現可能なベンチマークのために、4つの標準スイート(Spatial、Object、Goal、Long)すべてで、タスクごとに10エピソードを使用してください。これにより合計400エピソードとなり、公開された結果で使用されたプロトコルと一致します。成功率は評価シードによって数パーセント変動する可能性があるため、3つのシードで平均を取ることをお勧めします。
lerobot-eval は、すべての成功率の隣に 95% の Wilson 信頼区間(pc_success_ci95)を報告します。10 エピソードでタスクのスコアが 9/10 の場合、区間はおよそ 60% から 98% となり、400 エピソードのスーートの合計が 80% の場合、区間はおよそ 76% から 84% となります。あるタスクで信頼区間が重なる 2 つのポリシーは、その実行ではそのタスクで差があるとは示されていません。この区間は、どのエピソードが抽出されたかをカバーしますが、ポリシーの学習シードはカバーしません。学習シードを測定するには、1 回以上の学習実行が必要です。
To compare two policies on the same episodes, use the same `--seed`, keep `--env.init_states=true`, and run each task in a single batch (`--eval.batch_size` equal to episodes per task).
トレーニング
データセット
前処理済みのLIBEROデータセット2つは、LeRobotと完全に互換性があります。これらは同じスキーマを持つ同じデモを含んでおり、カメラフレームの保存方法が異なります:
| lerobot/libero | HuggingFaceVLA/libero | |
|---|---|---|
| エピソード / フレーム / タスク | 1,693 / 273,465 / 40 | 1,693 / 273,465 / 40 |
| カメラ | 2× 256×256×3 | 2× 256×256×3 |
| 状態 / 行動の次元 | 8 / 7 | 8 / 7 |
| データセット形式 | v3.0 | v3.0 |
| カメラエンコーディング | MP4動画 | parquet 形式の PNG |
| ダウンロードサイズ | 1.9 GB | 69.9 GB |
| 追加の依存関係 | ビデオバックエンド(torchcodecまたはpyav) | なし |
lerobot/liberoを推奨します: ダウンロードサイズが37分の1に縮小され、読み込み速度は同等(ワーカーあたり約330サンプル/秒)です。動画の再エンコードはわずかに劣化します。動画デコードバックエンドをインストールできない場合は、画像ベースのバリアントを使用してください。
参考として、Physical Intelligence が公開した元のデータセットは以下の通りです:
Pin `--dataset.revision=` when reporting results — Hub datasets can be re-uploaded, and success rates are only comparable against the same data revision.
トレーニングコマンの例
推奨データセットでSmolVLAを学習します:
lerobot-train \
  --policy.type=smolvla \
  --policy.load_vlm_weights=true \
  --policy.push_to_hub=false \
  --dataset.repo_id=lerobot/libero \
  --dataset.video_backend=torchcodec \
  --output_dir=./outputs/libero_smolvla \
  --steps=100000 \
  --batch_size=64
Hub に結果を共有するには、--policy.push_to_hub=false を --policy.repo_id=${HF_USER}/libero-smolvla に置き換えてください。保存されたチェックポイントは、評価セクションに示されているように lerobot-eval で評価できます。
公開された結果の再現
LIBEROベンチマークにおけるPi0.5の結果を再現します。Physical IntelligenceのLIBEROベースモデル(pi05_libero)を使用し、HuggingFace LIBEROデータセットを用いて、8枚のH100 GPU上でバッチサイズ256、bfloat16で追加6kステップのファインチューニングを実行しました。
ファインチューニング済みモデル: lerobot/pi05_libero_finetuned
評価コマンド
lerobot-eval \
  --output_dir=./eval_logs/ \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --policy.path=lerobot/pi05_libero_finetuned \
  --policy.n_action_steps=10 \
  --env.max_parallel_tasks=1
n_action_steps=10を設定し、元のOpenPI実装と一致させました。
結果
| モデル | LIBERO Spatial | LIBERO Object | LIBERO Goal | LIBERO 10 | 平均 |
|---|---|---|---|---|---|
| Pi0.5 (LeRobot) | 97.0 | 99.0 | 98.0 | 96.0 | 97.5 |
これらの結果は、Physical Intelligenceが報告した元の結果と一致しています:
| モデル | LIBERO Spatial | LIBERO Object | LIBERO Goal | LIBERO 10 | 平均 |
|---|---|---|---|---|---|
| Pi0.5 (OpenPI) | 98.8 | 98.2 | 98.0 | 92.4 | 96.85 |